Sonic Phoenix: إعادة 7,246 أغنية منسية من الموت
هذه ترجمة آلية للنص الإنجليزي الأصلي. قد تضيع بعض الفروق الدقيقة، لذا تبقى النسخة الإنجليزية هي المرجع. اقرأ النص الأصلي بالإنجليزية
باختصار
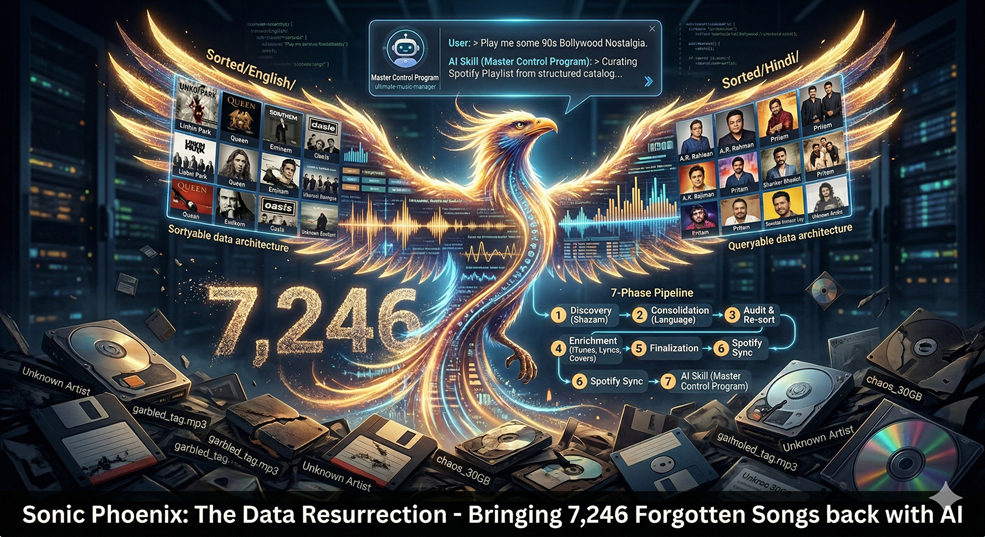
طلب مني طفلي أن أشغّل الأغاني التي كنت أستمع إليها في مثل سنه. طلب بسيط. قلت نعم، وأخرجت قرصًا خارجيًا مغطى بالغبار، ووصلته، وفتحت مجلدًا لم ألمسه منذ سنوات. وجدت 7,246 ملفًا صوتيًا ببيانات وصفية إما خاطئة أو ناقصة أو بلا معنى: حقول فنان تحتوي أرقام مقطوعات، وأسماء ألبومات لا تعني شيئًا، وعناوين لا علاقة لها بالأغنية الفعلية. لم أستطع العثور على مقطوعة واحدة باسمها. كان ذلك القرص يحمل كل ما نشأت عليه (Eminem وLinkin Park وA.R. Rahman وPritam وQueen) مدفونًا تحت طبقات من الوسوم المكسورة تراكمت عبر سنوات من النسخ والتحويل ونقل الملفات بين الأجهزة. وتحولت عطلة نهاية الأسبوع التي تلت ذلك إلى Sonic Phoenix.
البنية
ينقسم خط المعالجة إلى سبع مراحل، كل منها سلسلة من السكربتات الصغيرة التي تكتب حالتها على القرص. يمكنك التوقف بعد أي مرحلة، وفحص ملف JSON الوسيط، وتصحيح الأمور يدويًا، ثم الاستئناف دون إعادة العمل. لا شيء بارع في ذلك، مجرد إدارة حالة منضبطة تجعل مشكلة فوضوية قابلة للمعالجة.
| المرحلة | الغرض | المقياس الرئيسي |
|---|---|---|
| 1 - الاكتشاف | أخذ بصمة صوتية لكل ملف عبر Shazam | 7,246 ملفًا فُحصت، 4,177 جرى التعرف عليها (57.6%) |
| 2 - التوحيد | كتالوج SHA-256 وتصنيف اللغات | 7,160 إدخالًا مفهرسًا عبر 2 من المجموعات اللغوية |
| 3 - التدقيق وإعادة الفرز | دمج الفنانين المجزأين وفرض البنية | 1,365 عملية نقل توحيد، 968 مجلدًا فريدًا للفنانين |
| 4 - الإثراء | بيانات iTunes الوصفية وكلمات LrcLib وأغلفة الألبومات | 6,733 مقطوعة ببيانات ألبوم حقيقية |
| 5 - الإنهاء | التنظيف والضغط وقفل الكتالوج الرئيسي | 0 ملفات غير مرتبة متبقية |
| 6 - المزامنة مع Spotify | عكس المكتبة وتوليد قوائم التشغيل تلقائيًا | 95 فنانًا جرت مزامنتهم مع محرك الاكتشاف |
| 7 - مهارة الذكاء الاصطناعي (ClawHub) | تنسيق قوائم التشغيل عند الطلب عبر وكلاء OpenClaw | نُشرت باسم ultimate-music-manager على ClawHub |
البنية المستهدفة هي Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>. ظهرت من مجموعتي مجموعتان لغويتان: الإنجليزية (3,621 مقطوعة) والهندية (1,410 مقطوعات). والتصنيف ليس مثبتًا في الشيفرة، بل تحركه بالكامل ملفات JSON تلميحية تضعها في config/language_hints/. فإن كانت مجموعتك فرنسية ويابانية، فإن خط المعالجة ينتج Sorted/French/ وSorted/Japanese/ ولا شيء غيرهما.
في ذروته، قبل أن أحذف الملفات الصوتية، كانت المكتبة المرتبة تبدو هكذا:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
البناء
المرحلة 1: تجاهل كل وسم، والثقة بالصوت وحده
كان القرار الأول هو الأهم: التوقف عن الثقة بالبيانات الوصفية الموجودة. لم تكن وسوم ID3 في هذه الملفات ناقصة فحسب، بل كانت مضللة بنشاط. احتوت حقول الفنان على أرقام مقطوعات. وكانت أسماء الألبومات سلاسل بلا معنى. ولم تُشبه العناوين الأغنية الفعلية بشيء. كانت بعض الوسوم صحيحة، لكن لم تكن هناك طريقة لمعرفة أيها دون مصدر خارجي للحقيقة.
كان ذلك المصدر هو محرك البصمة الصوتية في ShazamIO. مررت كل ملف عبره للتحقق المتقاطع بين ما تدّعيه الوسوم وما هو عليه الصوت فعلًا. يشغّل السكربت (01D_shazam_all_files.py) 20 عملية بحث متزامنة في Shazam، ويفرغ النتائج إلى القرص كل 100 ملف، وهو قابل للاستئناف بالكامل: أوقفته ثلاث مرات خلال عطلة نهاية الأسبوع وفي كل مرة استأنف تمامًا من حيث توقف.
من بين 7,246 ملفًا، تعرّف Shazam بثقة على 4,177، أي بنسبة تعرف 57.6%. وحيث أكد Shazam الوسوم الموجودة، أُبقيت. وحيث خالفها، فازت النتيجة الصوتية. أما الملفات الـ 3,069 غير المتعرَّف عليها فكانت خليطًا من مقطوعات بوليوود غير معروفة وموسيقى هندية إقليمية وملفات تالفة أو قصيرة جدًا للمطابقة الصوتية. وقد انتقلت إلى حل من ثلاث طبقات: نتيجة Shazam → وسوم ID3 الموجودة (بعد تنظيفها وإلغاء توحيدها) → تحليل اسم الملف كملاذ أخير. ويظهر الكتالوج النهائي التفصيل: 6,925 إدخالًا حُلّت عبر ID3 (جرى التحقق منها أو تصحيحها بواسطة Shazam حيثما أمكن)، و79 من Shazam وحده، و156 من بديل اسم الملف.
المرحلتان 2–3: مشكلة اللغة ومشكلة تجزؤ الفنانين
كان تصنيف اللغة سهلًا للمقطوعات الإنجليزية لكنه انهار فورًا مع الهندية. المشكلة: ترى langdetect الهندية المكتوبة بحروف لاتينية (“Tujhe Dekha Toh Yeh Jaana Sanam”) فتصنفها إنجليزية. وانتهت كل أغنية بوليوودية بعنوان مكتوب بحروف لاتينية في المجموعة الخاطئة.
كان الحل ملفات تلميح لغوية صريحة: إعدادات JSON تحت config/language_hints/ تسرد فنانين معروفين وكلمات مفتاحية مميزة ورموز لغات. ضع ملف Hindi.json بـ "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"] فيُوجَّه هؤلاء الفنانون قسرًا إلى المجموعة الهندية بصرف النظر عما تظنه langdetect. وكان خط المعالجة يحمّل هذه الملفات وقت التشغيل دون أي معرفة لغوية مثبتة في الشيفرة نفسها.
ثم جاءت مشكلة تجزؤ الفنانين. بعد الفرز الأولي صار لدي مجلدات منفصلة لـ Akon feat. Eminem وAkon ft Snoop Dogg وAKON، وكلها للفنان الرئيسي نفسه، موزعة على ثلاثة أدلة. استخدمت مرحلة التوحيد (03A_consolidate_by_artist.py) مطابقة تقريبية عند عتبة تشابه 70% مع خريطة تجاوز يدوية للأسماء المرجعية. ونفّذت 1,365 عملية دمج للمجلدات لتختزل الفوضى إلى 968 دليلًا نظيفًا للفنانين.
وقدّم المُلزِم البنيوي الأخير (03D_titanium_resort.py) ضمانًا: بعد تشغيله، يلتزم كل ملف تحت Sorted/ بتسلسل Language/Artist/Album/Artist - Title.ext. وما لا يلتزم يُعاد فرزه أو يُعلَّم. وحين انتهت المرحلة 3 كانت المكتبة قد انتقلت من كومة مسطحة من 7,246 ملفًا إلى تسلسل هرمي منظم بلا ملفات يتيمة.
المرحلة 4: الإثراء، جعل البيانات الوصفية ذات قيمة
فرز الملفات في المجلدات الصحيحة نصف العمل. والنصف الآخر هو جعل كل ملف يصف نفسه: وسوم ID3 صحيحة، وأغلفة مضمَّنة، وكلمات متزامنة. استخدمت ثلاثة مصادر خارجية:
- واجهة iTunes Search API لأسماء الفنانين المرجعية وعناوين الألبومات وتواريخ الإصدار وأغلفة 1000×1000. لا تتطلب مفتاح API. ويدوّر السكربت الاستعلامات بين رمزي البلدين US وGB لتجنب حدود المعدل لكل منطقة.
- LrcLib للكلمات المتزامنة (تلك التي تنتقل كلمة بكلمة في المشغّل). مجاني وبلا مصادقة.
- تعريف Shazam الأصلي كمرساة للحقيقة في المطابقة التقريبية مع نتائج iTunes.
يشغّل سكربت الإثراء (04I_polish_and_enrich_v6.py، النسخة السادسة، وهذا يخبرك كم حالة حدّية كشفتها هذه العملية) جولة إزالة ضوضاء بـ 14 نمطًا من التعبيرات النمطية قبل كتابة أي وسم. فهو يزيل الأجزاء الدخيلة: علامات الجودة (128kbps و320kbps وVBR وHQ)، ومخلفات الوصف (official video وfull song وdj remix)، وضوضاء متنوعة تراكمت في حقول الوسوم على مر السنين. ويكتشف حقول الفنان والعنوان المعكوسة بمقارنتها تقريبيًا مع حقيقة Shazam ويصححها تلقائيًا.
النتيجة: 6,733 من أصل 7,160 مقطوعة مفهرسة تحمل الآن بيانات ألبوم حقيقية. و103 مقطوعات لها أغلفة HD مضمَّنة. و25 لها كلمات متزامنة. والفجوات المتبقية في معظمها مقطوعات إقليمية لا تفهرسها iTunes، وهو قيد معروف أتتبعه لجولة إثراء مستقبلية مقابل MusicBrainz.
المرحلتان 5–6: الإنهاء وجسر Spotify
قفلت المرحلة 5 الكتالوج. يدمج 05I_finalize_catalog.py بيانات ID3 وShazam وتصنيف معالجة اللغة الطبيعية في ملف final_catalog.json واحد، وهو أثر للقراءة فقط بحجم 1.9 MB يتعامل معه المستهلكون اللاحقون بوصفه المصدر الوحيد للحقيقة. بعد الإنهاء: صفر ملفات صوتية غير مرتبة في أي مكان تحت جذر الموسيقى. ثم حذفتها جميعًا. 30 GB من الملفات الصوتية، اختفت. أما الـ 11 MB من حالة خط المعالجة في .data/، أي الكتالوجات وسجلات الإثراء وتعريفات Shazam، فهي ما يهم فعلًا. كل أغنية في الكتالوج موجودة على Spotify. الملفات المحلية كانت مجرد المادة الخام؛ البيانات الوصفية هي المنتج.
وجعلت المرحلة 6 الحذف بلا ألم. يطابق محرك مزامنة الاكتشاف (06E_spotify_discovery_sync.py) فنانين الكتالوج مع Spotify ويولد تلقائيًا قوائم “Essentials” حسب النوع. وقد عالج 95 فنانًا في أول تشغيل للمزامنة. وحال الخطأ 403 من Spotify عند إنشاء القوائم (كان التطبيق في وضع التطوير) دون هبوط القوائم المولّدة تلقائيًا، وهو إصلاح بنقرة واحدة في لوحة مطوري Spotify سأنجزه قبل التشغيل التالي.
المرحلة 6 ليست المكافأة. المكافأة هي أن الكتالوج منظم ومثرى بما يكفي لتسليمه إلى ذكاء اصطناعي، دون حاجة إلى ملفات صوتية.
المرحلة 7: مهارة الذكاء الاصطناعي، تنسيق قوائم التشغيل عند الطلب
بنت المراحل 1–6 مجموعة البيانات. أما المرحلة 7 فتضع ذكاءً اصطناعيًا فوقها.
نشرت المهارة على ClawHub باسم ultimate-music-manager. يستطيع أي وكيل متوافق مع OpenClaw (Claude Code وCodex وCopilot) تثبيتها وتشغيل خط المعالجة أو الاستعلام عن الكتالوج فورًا. وتتضمن حزمة المهارة المجموعة الكاملة لتعليمات خط المعالجة (SKILL.md)، وسكربتات مساعدة لفحوص ما قبل التشغيل ولوحات الحالة، وخطاف أمان يعترض العمليات المدمرة قبل تنفيذها.
هنا يؤتي مشروع عطلة نهاية الأسبوع ثماره. صار بوسعي أن أقول “أنشئ لي قائمة حنين لأغاني بوليوود من عقد الـ 90” أو “أعطني كل مقطوعات Eminem مرتبة حسب الألبوم” أو “أنشئ مزيجًا لرحلة برية من مجموعتي الإنجليزية، مع كثير من الروك”، ولدى الوكيل البيانات الوصفية المنظمة (الفنان والعنوان والألبوم واللغة والنوع) ليفعل ذلك فعلًا. فهو يقرأ final_catalog.json، ويرشّح وفق أي معايير أصفها بلغة طبيعية، ويدفع النتيجة إلى Spotify عبر محرك المزامنة في المرحلة 6. لا حاجة إلى ملفات صوتية محلية: فقط الكتالوج واشتراك في Spotify.
لم يعد الكتالوج النهائي قائمة مسطحة من أسماء الملفات. إنه مجموعة بيانات قابلة للاستعلام تقف خلف مهارة ذكاء اصطناعي منشورة تحوّل اللغة الطبيعية إلى قوائم تشغيل منسقة، بُنيت بالكامل من بيانات وصفية استخرجتها من موسيقاي أنا، لا من خوارزمية لا تعرف على ماذا نشأت.
المفاضلات
كانت نسبة تعرف Shazam البالغة 57.6% أكبر مفاجأة. توقعت أن تكون البصمة الصوتية رصاصة فضية: أعطها صوتًا واحصل على إجابة. وكانت كذلك للموسيقى الغربية الرائجة. أما للموسيقى الهندية الإقليمية، وبخاصة مقطوعات بوليوود القديمة والتسجيلات التعبدية، فلم يكن لدى قاعدة بيانات Shazam تغطية ببساطة. وقد التقط البديل ذو الطبقات الثلاث (Shazam → ID3 → اسم الملف) معظمها، لكن 156 مقطوعة ظلت تُحل بتحليل اسم الملف وحده، مما يعني أن بياناتها الوصفية لا تتجاوز جودة ما كتبه من نزّلها أول مرة. وهذه الإدخالات الـ 156 هي أقل سجلات الكتالوج ثقة.
تحكي النسخ الست من سكربت الإثراء (من 04A إلى 04I) قصتها بنفسها. كل نسخة موجودة لأن سابقتها تعطلت عند حالة حدّية لم أتوقعها: ترويسات ID3v2.3/v2.4 مختلطة لم تستطع Mutagen حفظها، وiTunes يعيد مقطوعة مختلفة تمامًا لاستعلام تقريبي، وحقول فنان وعنوان معكوسة جعلتها جولة إزالة الضوضاء أسوأ بدل أن تحسّنها. أبقيت كل نسخة في المستودع كسجل تاريخي. وقراءة 04A حتى 04I بالترتيب أسرع طريقة لفهم كل حالة حدّية للبيانات الوصفية قد تلقيها عليك مكتبة موسيقية.
أحرق فشل langdetect مع الهندية المكتوبة بحروف لاتينية ساعات من وقتي. كان لدي أكثر من 200 مقطوعة بوليوودية جالسة في المجموعة الإنجليزية قبل أن أدرك أن المصنِّف مخطئ بثقة تامة. كان نظام ملفات التلميح هو الحل، لكنه عملية يدوية: على شخص ما أن يُعدّ قوائم الفنانين والكلمات المفتاحية لكل لغة. ولمجموعة بلغتين (الإنجليزية والهندية) كان ذلك مقبولًا. أما لمكتبة متعددة اللغات بأكثر من 10 لغات فسيكون استثمارًا مسبقًا كبيرًا.
تمثل الإدخالات الـ 690 في تقرير عدم التطابق مقطوعات أعادت فيها iTunes نتيجة لا تطابق تعريف Shazam. بعضها نسخ بديلة مشروعة (تسجيلات حية وإعادات إتقان). وبعضها مطابقات خاطئة فعلًا من بحث iTunes التقريبي. يسجل سكربت الإثراء هذه الحالات لكنه لا يتجاوز حقيقة Shazam، وهو خيار متحفظ يترك مقطوعة أحيانًا ناقصة الإثراء بدل أن يخطئ في وسمها.
ما تعلمته
سمع طفلي الأغاني. كان ذلك هو الهدف كله، وكاد يضيع وسط الهندسة. كومة من 7,246 ملفًا صوتيًا بلا وسوم هي مشكلة بيانات لا مجموعة موسيقية، ومشكلات البيانات هي بالضبط ما صارت أدوات الذكاء الاصطناعي بارعة فيه. كان خط المعالجة الذي بنيته في عطلة نهاية أسبوع سيستغرق أسابيع من الفرز اليدوي قبل بضع سنوات. أما الآن فالكتالوج منظم بما يكفي لتبني لي مهارة ذكاء اصطناعي قائمة تشغيل في ثوانٍ من بيانات وصفية لم أكن لأملك الصبر على تنسيقها يدويًا. حذفت 30 GB من الصوت وأبقيت 11 MB من JSON. لم تكن الملفات هي الهدف يومًا، بل البيانات، ومجموعات البيانات تتراكم.

بقلم
Rohit Buraniمهندس ذكاء اصطناعي يبني أنظمة محلية أولًا وبنية تحتية مستضافة ذاتيًا وأدوات مستقلة من المختبر.