Sonic Phoenix: 7,246টি ভুলে যাওয়া গানকে মৃত্যুর হাত থেকে ফিরিয়ে আনা
এটি ইংরেজি মূল লেখাটির মেশিন অনুবাদ। কিছু সূক্ষ্মতা হারিয়ে যেতে পারে, তাই ইংরেজি সংস্করণই মূল রেফারেন্স। মূল ইংরেজি লেখাটি পড়ুন
সংক্ষেপে
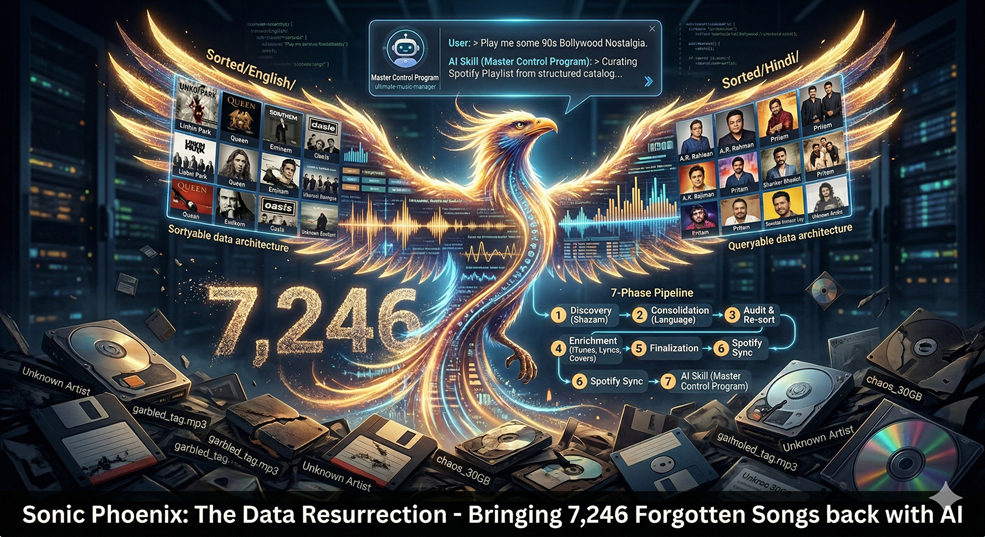
আমার সন্তান আমাকে বলল ওর বয়সে আমি যেসব গান শুনতাম সেগুলো চালাতে। সহজ অনুরোধ। আমি হ্যাঁ বললাম, ধুলো জমা একটি এক্সটার্নাল ড্রাইভ বের করলাম, লাগালাম, আর এমন একটি ফোল্ডার খুললাম যা বছরের পর বছর ছুঁইনি। যা পেলাম তা হলো 7,246টি অডিও ফাইল, যাদের মেটাডেটা হয় ভুল, নয় অনুপস্থিত, নয় অর্থহীন: শিল্পীর ঘরে ট্র্যাক নম্বর, অ্যালবামের নাম যার কোনো মানে নেই, শিরোনাম যার আসল গানের সঙ্গে কোনো সম্পর্ক নেই। আমি একটিও ট্র্যাক নাম ধরে খুঁজে পাইনি। সেই ড্রাইভে ছিল আমি যা শুনে বড় হয়েছি সবকিছু (Eminem, Linkin Park, A.R. Rahman, Pritam, Queen), বছরের পর বছর রিপ করা, কনভার্ট করা আর ডিভাইসের মধ্যে ফাইল সরানো থেকে জমা হওয়া ভাঙা ট্যাগের স্তরের নিচে চাপা। তার পরের সপ্তাহান্তটাই হয়ে উঠল Sonic Phoenix।
আর্কিটেকচার
পাইপলাইনটি সাত ধাপে বিভক্ত, প্রতিটি ধাপ ছোট স্ক্রিপ্টের একটি ধারা যারা নিজেদের অবস্থা ডিস্কে লেখে। আপনি যেকোনো ধাপের পরে থামতে পারেন, মাঝের JSON পরীক্ষা করতে পারেন, হাতে জিনিস ঠিক করতে পারেন, আর কাজ পুনরায় না করে আবার শুরু করতে পারেন। এতে চালাকির কিছু নেই, শুধু সুশৃঙ্খল স্টেট ম্যানেজমেন্ট যা একটি বিশৃঙ্খল সমস্যাকে নাগালে আনে।
| ধাপ | উদ্দেশ্য | প্রধান মেট্রিক |
|---|---|---|
| 1 - আবিষ্কার | Shazam দিয়ে প্রতিটি ফাইলের অ্যাকোস্টিক ফিঙ্গারপ্রিন্ট | 7,246টি ফাইল স্ক্যান, 4,177টি শনাক্ত (57.6%) |
| 2 - একত্রীকরণ | SHA-256 ক্যাটালগ ও ভাষা শ্রেণিবিন্যাস | 2টি ভাষা-দলে 7,160টি ক্যাটালগভুক্ত এন্ট্রি |
| 3 - নিরীক্ষা ও পুনঃবাছাই | ছড়ানো শিল্পী মেলানো, কাঠামো আরোপ | 1,365টি একত্রীকরণ সরানো, 968টি অনন্য শিল্পী ফোল্ডার |
| 4 - সমৃদ্ধকরণ | iTunes মেটাডেটা, LrcLib-এর কথা, কভার আর্ট | 6,733টি ট্র্যাক আসল অ্যালবাম ডেটাসহ |
| 5 - চূড়ান্তকরণ | পরিষ্কার, সংকুচিত, মাস্টার ক্যাটালগ লক | 0টি অবাছাই ফাইল অবশিষ্ট |
| 6 - Spotify সিঙ্ক | লাইব্রেরির প্রতিচ্ছবি ও স্বয়ংক্রিয় প্লেলিস্ট তৈরি | 95 জন শিল্পী ডিসকভারি ইঞ্জিনে সিঙ্ক |
| 7 - AI স্কিল (ClawHub) | OpenClaw এজেন্টের মাধ্যমে চাহিদামতো প্লেলিস্ট কিউরেশন | ClawHub-এ ultimate-music-manager নামে প্রকাশিত |
লক্ষ্য কাঠামো হলো Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>। আমার সংগ্রহ থেকে দুটি ভাষা-দল উঠে এসেছে: ইংরেজি (3,621টি ট্র্যাক) আর হিন্দি (1,410টি ট্র্যাক)। শ্রেণিবিন্যাস কোডে হার্ডকোড করা নয়, এটি সম্পূর্ণ চলে আপনি config/language_hints/-এ যেসব JSON ইঙ্গিত-ফাইল রাখেন সেগুলো দিয়ে। আপনার সংগ্রহ যদি ফরাসি ও জাপানি হয়, পাইপলাইন তৈরি করে Sorted/French/ ও Sorted/Japanese/, আর কিছু নয়।
চূড়ান্ত অবস্থায়, অডিও ফাইল মোছার আগে, বাছাই করা লাইব্রেরি দেখতে এমন ছিল:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
নির্মাণ
ধাপ 1: প্রতিটি ট্যাগ উপেক্ষা করুন, শুধু অডিওকে বিশ্বাস করুন
প্রথম সিদ্ধান্তটাই সবচেয়ে গুরুত্বপূর্ণ ছিল: বিদ্যমান মেটাডেটাকে বিশ্বাস করা বন্ধ করা। এই ফাইলগুলোর ID3 ট্যাগ শুধু অসম্পূর্ণ ছিল না, সক্রিয়ভাবে বিভ্রান্তিকর ছিল। শিল্পীর ঘরে ট্র্যাক নম্বর ছিল। অ্যালবামের নাম অর্থহীন স্ট্রিং ছিল। শিরোনামের সঙ্গে আসল গানের কোনো মিল ছিল না। কিছু ট্যাগ ঠিক ছিল, কিন্তু বাইরের সত্যের উৎস ছাড়া কোনগুলো তা বোঝার উপায় ছিল না।
সেই সত্যের উৎস ছিল ShazamIO-র অ্যাকোস্টিক ফিঙ্গারপ্রিন্টিং ইঞ্জিন। ট্যাগ যা দাবি করে আর অডিও আসলে যা, তার ক্রস-যাচাই করতে আমি প্রতিটি ফাইল তার মধ্য দিয়ে চালিয়েছি। স্ক্রিপ্টটি (01D_shazam_all_files.py) 20টি সমান্তরাল Shazam লুকআপ চালায়, প্রতি 100টি ফাইলে ফলাফল ডিস্কে লেখে, এবং সম্পূর্ণ পুনরায় শুরুযোগ্য: সপ্তাহান্তে আমি তিনবার এটি থামিয়েছি এবং প্রতিবার ঠিক যেখানে ছিল সেখান থেকে চালু হয়েছে।
7,246টি ফাইলের মধ্যে Shazam 4,177টিকে নিশ্চিতভাবে শনাক্ত করল, অর্থাৎ 57.6% শনাক্তকরণ হার। যেখানে Shazam বিদ্যমান ট্যাগ নিশ্চিত করেছে, সেগুলো রাখা হয়েছে। যেখানে ভিন্নমত, অ্যাকোস্টিক ফলাফল জিতেছে। বাকি 3,069টি অশনাক্ত ফাইল ছিল অখ্যাত Bollywood ট্র্যাক, আঞ্চলিক ভারতীয় সংগীত, এবং অ্যাকোস্টিক মিলের জন্য খুব নষ্ট বা খুব ছোট ফাইলের মিশ্রণ। সেগুলো তিন-স্তরের সমাধানে গেছে: Shazam ফলাফল → বিদ্যমান ID3 ট্যাগ (পরিষ্কার ও অ-স্বাভাবিকীকৃত) → শেষ উপায় হিসেবে ফাইলের নাম বিশ্লেষণ। চূড়ান্ত ক্যাটালগে বিভাজনটি দেখা যায়: 6,925টি এন্ট্রি ID3 দিয়ে সমাধান হয়েছে (যেখানে সম্ভব Shazam দিয়ে ক্রস-যাচাইকৃত বা সংশোধিত), 79টি শুধু Shazam থেকে, আর 156টি ফাইলের নামের বিকল্প থেকে।
ধাপ 2–3: ভাষার সমস্যা আর শিল্পী ছড়িয়ে পড়ার সমস্যা
ইংরেজি ট্র্যাকের জন্য ভাষা শ্রেণিবিন্যাস সরল ছিল, কিন্তু হিন্দিতে তা সঙ্গে সঙ্গে ভেঙে পড়ল। সমস্যা: langdetect লিপ্যন্তরিত হিন্দি (ইংরেজি অক্ষরে লেখা হিন্দি, “Tujhe Dekha Toh Yeh Jaana Sanam”) দেখে সেটাকে ইংরেজি বলে চিহ্নিত করে। রোমান শিরোনামের প্রতিটি Bollywood গান ভুল দলে পড়ল।
সমাধান ছিল স্পষ্ট ভাষা-ইঙ্গিত ফাইল: config/language_hints/-এর অধীনে JSON কনফিগ, যাতে পরিচিত শিল্পী, বৈশিষ্ট্যসূচক কীওয়ার্ড আর ভাষা কোড তালিকাভুক্ত। "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"] সহ একটি Hindi.json রাখলে সেই শিল্পীরা জোর করে হিন্দি দলে চলে যায়, langdetect যা-ই ভাবুক। পাইপলাইন এগুলো রানটাইমে লোড করত, কোডে ভাষা সম্পর্কে কোনো হার্ডকোড জ্ঞান ছাড়াই।
তারপর এল শিল্পী ছড়িয়ে পড়ার সমস্যা। প্রাথমিক বাছাইয়ের পর আমার কাছে Akon feat. Eminem, Akon ft Snoop Dogg আর AKON-এর আলাদা ফোল্ডার ছিল, সবই একই প্রধান শিল্পীর, তিনটি ডিরেক্টরিতে ছড়ানো। একত্রীকরণ পাস (03A_consolidate_by_artist.py) 70% সাদৃশ্য সীমায় ফাজি ম্যাচিং এবং আদর্শ নামের জন্য হাতে বানানো ওভাররাইড ম্যাপ ব্যবহার করেছে। এটি 1,365টি ফোল্ডার মার্জ করে জঞ্জাল নামিয়ে এনেছে 968টি পরিচ্ছন্ন শিল্পী ডিরেক্টরিতে।
চূড়ান্ত কাঠামো-প্রয়োগকারী (03D_titanium_resort.py) একটি নিশ্চয়তা দিয়েছে: এটি চলার পর Sorted/-এর অধীনের প্রতিটি ফাইল Language/Artist/Album/Artist - Title.ext স্তরবিন্যাস মেনে চলে। যা মানে না তা পুনরায় বাছাই হয় বা চিহ্নিত হয়। ধাপ 3 শেষ হওয়ার পর লাইব্রেরি 7,246টি ফাইলের সমতল স্তূপ থেকে একটি কাঠামোবদ্ধ স্তরবিন্যাসে পৌঁছেছে, কোনো অনাথ ফাইল ছাড়া।
ধাপ 4: সমৃদ্ধকরণ, মেটাডেটাকে মূল্যবান করা
ফাইলগুলো সঠিক ফোল্ডারে বাছাই করা অর্ধেক কাজ। বাকি অর্ধেক হলো প্রতিটি ফাইলকে স্বয়ং-বর্ণনাকারী করা: সঠিক ID3 ট্যাগ, এমবেড করা কভার আর্ট, সিঙ্ক্রোনাইজড লিরিক্স। আমি তিনটি বাইরের উৎস ব্যবহার করেছি:
- iTunes Search API আদর্শ শিল্পীর নাম, অ্যালবামের শিরোনাম, প্রকাশের তারিখ আর 1000×1000 কভার আর্টের জন্য। কোনো API কী লাগে না। স্ক্রিপ্ট প্রতি-অঞ্চলের হার-সীমা এড়াতে US ও GB দেশ কোডের মধ্যে কোয়েরি ঘোরায়।
- LrcLib সিঙ্ক্রোনাইজড কথার জন্য (যেগুলো প্লেয়ারে শব্দে শব্দে স্ক্রল করে)। বিনামূল্যে, অথেনটিকেশন ছাড়া।
- Shazam-এর মূল শনাক্তকরণ iTunes ফলাফলের সঙ্গে ফাজি ম্যাচিংয়ের জন্য সত্যের ভিত্তি হিসেবে।
সমৃদ্ধকরণ স্ক্রিপ্ট (04I_polish_and_enrich_v6.py, ষষ্ঠ সংস্করণ, যা বলে দেয় এই প্রক্রিয়া কতগুলো প্রান্তিক ক্ষেত্র উন্মোচন করেছে) কোনো ট্যাগ লেখার আগে 14-প্যাটার্নের রেজেক্স ডিনয়েজ পাস চালায়। এটি জঞ্জাল টুকরো ছাঁটে: মানের চিহ্ন (128kbps, 320kbps, VBR, HQ), বর্ণনার অবশেষ (official video, full song, dj remix), আর বছরের পর বছর ট্যাগের ঘরে জমা হওয়া নানা রকম কোলাহল। এটি Shazam-এর সত্যের ভিত্তির সঙ্গে ফাজি তুলনা করে উল্টে যাওয়া শিল্পী/শিরোনামের ঘর ধরে এবং নিজে নিজে ঠিক করে।
ফলাফল: ক্যাটালগভুক্ত 7,160টির মধ্যে 6,733টি ট্র্যাক এখন আসল অ্যালবাম মেটাডেটা বহন করে। 103টি ট্র্যাকে এমবেড করা HD কভার আর্ট আছে। 25টিতে সিঙ্ক্রোনাইজড লিরিক্স আছে। বাকি ফাঁকগুলো বেশির ভাগ আঞ্চলিক ট্র্যাক যেগুলো iTunes ইনডেক্স করে না, একটি জানা সীমাবদ্ধতা যা আমি MusicBrainz-এর বিপরীতে ভবিষ্যৎ সমৃদ্ধকরণ পাসের জন্য নজরে রাখছি।
ধাপ 5–6: চূড়ান্তকরণ আর Spotify সেতু
ধাপ 5 ক্যাটালগ লক করেছে। 05I_finalize_catalog.py ID3, Shazam ও NLP শ্রেণিবিন্যাস ডেটাকে একটি final_catalog.json-এ মেলায়, 1.9 MB-এর একটি রিড-অনলি আর্টিফ্যাক্ট যাকে পরবর্তী ব্যবহারকারীরা একমাত্র সত্যের উৎস হিসেবে গণ্য করে। চূড়ান্তকরণের পর: মিউজিক রুটের কোথাও একটিও অবাছাই অডিও ফাইল নেই। আর তারপর আমি সেগুলো সবই মুছে ফেললাম। 30 GB অডিও ফাইল, উধাও। .data/-এ পাইপলাইনের স্টেটের 11 MB, মানে ক্যাটালগ, সমৃদ্ধকরণের রেকর্ড, Shazam-এর শনাক্তকরণ, আসলে সেটাই গুরুত্বপূর্ণ। ক্যাটালগের প্রতিটি গান Spotify-তে আছে। স্থানীয় ফাইলগুলো ছিল শুধু কাঁচামাল; মেটাডেটাই পণ্য।
ধাপ 6 মোছাকে যন্ত্রণাহীন করেছে। ডিসকভারি সিঙ্ক ইঞ্জিন (06E_spotify_discovery_sync.py) ক্যাটালগের শিল্পীদের Spotify-র সঙ্গে মেলায় এবং ঘরানাভিত্তিক “Essentials” প্লেলিস্ট স্বয়ংক্রিয়ভাবে বানায়। প্রথম সিঙ্ক রানে এটি 95 জন শিল্পী প্রসেস করেছে। প্লেলিস্ট তৈরিতে Spotify-র 403 (অ্যাপটি ডেভেলপমেন্ট মোডে ছিল) স্বয়ংক্রিয় প্লেলিস্টগুলো নামতে দেয়নি, যা Spotify Developer Dashboard-এ এক ক্লিকের সমাধান এবং পরের রানের আগে আমি সেটা মেটাব।
ধাপ 6 পুরস্কার নয়। পুরস্কার হলো ক্যাটালগ এতটাই কাঠামোবদ্ধ ও সমৃদ্ধ যে একটি AI-কে তা দেওয়া যায়, কোনো অডিও ফাইল ছাড়াই।
ধাপ 7: AI স্কিল, চাহিদামতো প্লেলিস্ট কিউরেশন
ধাপ 1–6 ডেটাসেট বানিয়েছে। ধাপ 7 তার ওপরে একটি AI বসায়।
আমি স্কিলটি ClawHub-এ ultimate-music-manager নামে প্রকাশ করেছি। যেকোনো OpenClaw-সঙ্গত এজেন্ট (Claude Code, Codex, Copilot) এটি ইনস্টল করে সঙ্গে সঙ্গে পাইপলাইন চালাতে বা ক্যাটালগে কোয়েরি করতে পারে। স্কিল প্যাকেজে আছে পাইপলাইনের নির্দেশনার সম্পূর্ণ সেট (SKILL.md), প্রি-ফ্লাইট পরীক্ষা ও স্ট্যাটাস ড্যাশবোর্ডের জন্য সহায়ক স্ক্রিপ্ট, এবং একটি নিরাপত্তা হুক যা ধ্বংসাত্মক ক্রিয়াগুলো চলার আগেই আটকে দেয়।
এখানেই সপ্তাহান্তের প্রজেক্ট ফল দেয়। আমি এখন বলতে পারি “আমার জন্য 90-এর দশকের Bollywood নস্টালজিয়া প্লেলিস্ট বানাও” বা “আমাকে প্রতিটি Eminem ট্র্যাক অ্যালবাম অনুযায়ী সাজিয়ে দাও” বা “আমার ইংরেজি সংগ্রহ থেকে রোড ট্রিপ মিক্স বানাও, রকের ভাগ বেশি”, আর এজেন্টের কাছে সত্যিই তা করার কাঠামোবদ্ধ মেটাডেটা আছে: শিল্পী, শিরোনাম, অ্যালবাম, ভাষা, ঘরানা। সে final_catalog.json পড়ে, আমি সহজ ভাষায় যে মানদণ্ডই বর্ণনা করি তা দিয়ে ছাঁকে, এবং ফলাফল ধাপ 6-এর সিঙ্ক ইঞ্জিনের মাধ্যমে Spotify-তে পাঠিয়ে দেয়। স্থানীয় অডিও ফাইল লাগে না: শুধু ক্যাটালগ আর একটি Spotify সাবস্ক্রিপশন।
চূড়ান্ত ক্যাটালগ আর ফাইলের নামের সমতল তালিকা নয়। এটি একটি প্রকাশিত AI স্কিলের পেছনে বসা কোয়েরিযোগ্য ডেটাসেট, যা সহজ ভাষাকে কিউরেট করা প্লেলিস্টে রূপান্তর করে, সম্পূর্ণ আমার নিজের সংগীত থেকে বের করা মেটাডেটা দিয়ে তৈরি, এমন অ্যালগরিদম থেকে নয় যা জানে না আমি কী শুনে বড় হয়েছি।
সমঝোতা
57.6% Shazam শনাক্তকরণ হারই ছিল সবচেয়ে বড় বিস্ময়। আমি আশা করেছিলাম অ্যাকোস্টিক ফিঙ্গারপ্রিন্টিং হবে সিলভার বুলেট: অডিও দাও, উত্তর পাও। মূলধারার পশ্চিমা সংগীতের জন্য তা ছিল। আঞ্চলিক ভারতীয় সংগীতের জন্য, বিশেষ করে পুরোনো Bollywood ট্র্যাক ও ভক্তিমূলক রেকর্ডিংয়ের জন্য, Shazam-এর ডেটাবেসে সোজা কথায় কভারেজ ছিল না। তিন-স্তরের বিকল্প (Shazam → ID3 → ফাইলের নাম) বেশির ভাগকে ধরেছে, কিন্তু 156টি ট্র্যাক তবুও শুধু ফাইলের নাম বিশ্লেষণ দিয়ে সমাধান হয়েছে, মানে তাদের মেটাডেটা ততটাই ভালো যতটা মূল ডাউনলোডকারী টাইপ করেছিলেন। এই 156টি এন্ট্রি ক্যাটালগের সবচেয়ে কম আস্থার রেকর্ড।
সমৃদ্ধকরণ স্ক্রিপ্টের ছয়টি সংস্করণ (04A থেকে 04I পর্যন্ত) নিজেদের গল্প নিজেরা বলে। প্রতিটি সংস্করণ আছে কারণ আগেরটি এমন একটি প্রান্তিক ক্ষেত্রে ভেঙেছিল যা আমি আন্দাজ করিনি: মিশ্র ID3v2.3/v2.4 হেডার যা Mutagen সংরক্ষণ করতে পারেনি, iTunes একটি ফাজি কোয়েরির জন্য সম্পূর্ণ আলাদা ট্র্যাক ফিরিয়ে দেওয়া, উল্টে যাওয়া শিল্পী/শিরোনামের ঘর যা ডিনয়েজ পাস ভালো না করে আরও খারাপ করেছে। আমি প্রতিটি সংস্করণ ঐতিহাসিক রেকর্ড হিসেবে রেপোতে রেখেছি। 04A থেকে 04I পর্যন্ত ক্রমানুসারে পড়াই বোঝার দ্রুততম উপায় যে একটি সংগীত লাইব্রেরি আপনার দিকে কতরকম মেটাডেটা প্রান্তিক ক্ষেত্র ছুড়ে দিতে পারে।
লিপ্যন্তরিত হিন্দিতে langdetect-এর ব্যর্থতা ঘণ্টার পর ঘণ্টা পুড়িয়েছে। আমার 200-র বেশি Bollywood ট্র্যাক ইংরেজি দলে বসে ছিল, তারপর বুঝলাম শ্রেণিবিন্যাসকারী পূর্ণ আত্মবিশ্বাসে ভুল। ইঙ্গিত-ফাইল ব্যবস্থাই ছিল সমাধান, কিন্তু এটি হাতের কাজ: কাউকে প্রতিটি ভাষার জন্য শিল্পী-তালিকা ও কীওয়ার্ড বাছতে হয়। দুই-ভাষার সংগ্রহের (ইংরেজি আর হিন্দি) জন্য এটা সামলানো গিয়েছিল। 10-এর বেশি ভাষার বহুভাষিক লাইব্রেরির জন্য এটা হবে উল্লেখযোগ্য অগ্রিম বিনিয়োগ।
অমিল রিপোর্টের 690টি এন্ট্রি এমন ট্র্যাক যেখানে iTunes এমন ফলাফল ফিরিয়েছে যা Shazam-এর শনাক্তকরণের সঙ্গে মেলেনি। কিছু ছিল বৈধ বিকল্প সংস্করণ (লাইভ রেকর্ডিং, রিমাস্টার)। কিছু সত্যিই iTunes-এর ফাজি সার্চ থেকে আসা ভুল মিল। সমৃদ্ধকরণ স্ক্রিপ্ট এগুলো লগ করে কিন্তু Shazam-এর সত্যের ভিত্তিকে ওভাররাইড করে না, একটি রক্ষণশীল পছন্দ যা মাঝেমধ্যে কোনো ট্র্যাককে ভুল ট্যাগ করার বদলে কম সমৃদ্ধ রেখে দেয়।
যা শিখলাম
আমার সন্তান গানগুলো শুনতে পেয়েছে। পুরো উদ্দেশ্য সেটাই ছিল, আর তা প্রায় ইঞ্জিনিয়ারিংয়ের মধ্যে হারিয়ে যাচ্ছিল। 7,246টি ট্যাগহীন অডিও ফাইলের স্তূপ একটি ডেটার সমস্যা, সংগীতের সংগ্রহ নয়, আর ডেটার সমস্যাই ঠিক সেটা যাতে AI টুলিং ভালো হয়ে উঠেছে। এক সপ্তাহান্তে আমি যে পাইপলাইন বানিয়েছি, কয়েক বছর আগে সেটা হাতে বাছাই করতে সপ্তাহ লেগে যেত। এখন ক্যাটালগ এতটাই কাঠামোবদ্ধ যে একটি AI স্কিল সেকেন্ডে আমার জন্য প্লেলিস্ট বানিয়ে দেয়, এমন মেটাডেটা থেকে যা আমি হাতে সাজানোর ধৈর্য কখনও পেতাম না। আমি 30 GB অডিও মুছেছি আর 11 MB JSON রেখেছি। ফাইলগুলো কখনও উদ্দেশ্য ছিল না, ডেটাই ছিল, আর ডেটাসেট চক্রবৃদ্ধি হয়।

লেখক
Rohit BuraniAI ইঞ্জিনিয়ার, যিনি ল্যাব থেকে লোকাল-ফার্স্ট সিস্টেম, সেলফ-হোস্টেড অবকাঠামো এবং স্বয়ংক্রিয় টুল তৈরি করেন।