Sonic Phoenix:让 7,246 首被遗忘的歌起死回生
本文是英文原文的机器翻译,部分细节可能有所损失,请以英文版本为准。 阅读英文原文
要点速览
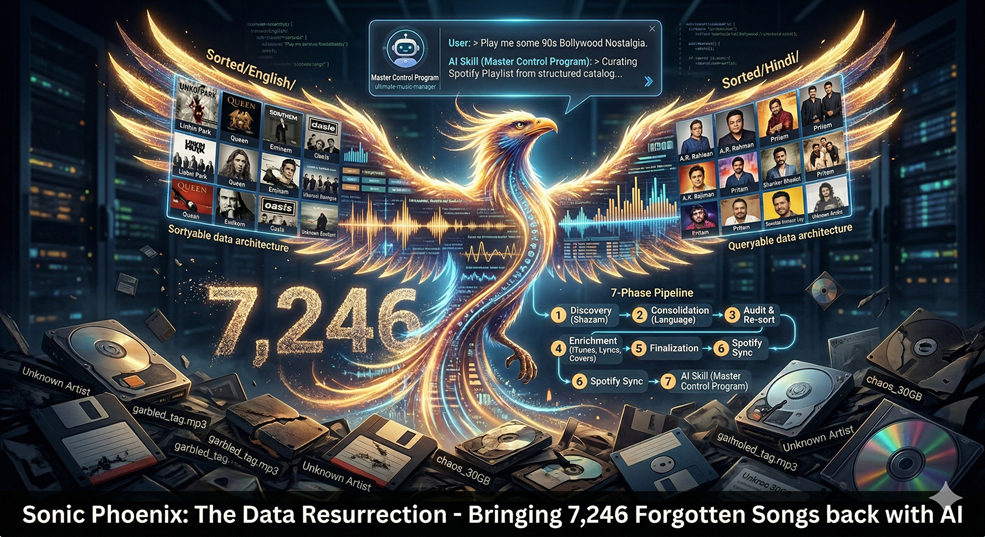
我的孩子让我放我在他这个年纪听的歌。很简单的请求。我答应了,翻出一块落满灰的外置硬盘,接上,打开一个我多年没碰过的文件夹。里面是 7,246 个音频文件,元数据要么错,要么缺,要么毫无意义:艺术家字段里是曲目编号,专辑名是没有意义的字符串,标题和真正的歌毫不相干。我连一首曲目都没法按名字找到。那块硬盘里有我成长过程中的一切(Eminem、Linkin Park、A.R. Rahman、Pritam、Queen),埋在多年翻录、转换、在设备间来回搬运积累下来的层层损坏标签之下。接下来的那个周末,变成了 Sonic Phoenix。
架构
流水线分为七个阶段,每个阶段是一串把状态写到磁盘上的小脚本。你可以在任何阶段之后停下,检查中间的 JSON,手工修正,然后不用重做任何工作就继续。这里面没有什么聪明之处,只是有纪律的状态管理,让一个混乱的问题变得可以处理。
| 阶段 | 目的 | 关键指标 |
|---|---|---|
| 1 - 发现 | 用 Shazam 对每个文件做声学指纹 | 扫描 7,246 个文件,识别 4,177 个(57.6%) |
| 2 - 整合 | SHA-256 编目与语言分类 | 2 个语言组共 7,160 条目录条目 |
| 3 - 审计与重新分拣 | 合并散落的艺术家,强制执行结构 | 1,365 次合并移动,968 个唯一艺术家文件夹 |
| 4 - 丰富 | iTunes 元数据、LrcLib 歌词、封面图 | 6,733 首曲目有真实专辑数据 |
| 5 - 定稿 | 清理、压缩、锁定主目录 | 剩余 0 个未分拣文件 |
| 6 - Spotify 同步 | 镜像曲库并自动生成歌单 | 95 位艺术家同步到发现引擎 |
| 7 - AI 技能(ClawHub) | 通过 OpenClaw 智能体按需策划歌单 | 在 ClawHub 上以 ultimate-music-manager 发布 |
目标结构是 Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>。我的收藏里分出了两个语言组:英语(3,621 首)和印地语(1,410 首)。分类没有写死在代码里,完全由你放在 config/language_hints/ 里的 JSON 提示文件驱动。如果你的收藏是法语和日语,流水线就会生成 Sorted/French/ 和 Sorted/Japanese/,仅此而已。
在巅峰状态,也就是删除音频文件之前,分拣好的曲库长这样:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
搭建
阶段 1:无视每一个标签,只信音频
第一个决定最重要:不再相信已有的元数据。 这些文件的 ID3 标签不只是不完整,而是在主动误导。艺术家字段里是曲目编号。专辑名是毫无意义的字符串。标题和真正的歌毫无相似之处。有些标签是对的,但没有外部的事实来源,就没法知道是哪些。
那个事实来源就是 ShazamIO 的声学指纹引擎。我把每个文件都送进去,交叉核对标签的声称和音频的实际内容。脚本(01D_shazam_all_files.py)并发运行 20 个 Shazam 查询,每 100 个文件把结果写入磁盘,完全可以断点续跑:这个周末我把它停了三次,每次都从中断处接着跑。
在 7,246 个文件中,Shazam 确定识别出 4,177 个,识别率 57.6%。Shazam 确认已有标签的地方,标签保留。两者不一致时,声学结果胜出。剩下的 3,069 个未识别文件,混杂着冷门的宝莱坞曲目、地区性的印度音乐,以及太差或太短而无法做声学匹配的文件。它们进入三层兜底:Shazam 结果 → 已有的 ID3 标签(清理并去规范化)→ 最后手段的文件名解析。最终目录给出了明细:6,925 条通过 ID3 解决(尽可能由 Shazam 交叉验证或纠正),79 条仅来自 Shazam,156 条来自文件名兜底。
阶段 2–3:语言问题与艺术家碎片化问题
英语曲目的语言分类很直接,但到了印地语立刻崩溃。问题是:langdetect 看到音译的印地语(用英文字母写的印地语,如“Tujhe Dekha Toh Yeh Jaana Sanam”)就把它判成英语。每一首标题是罗马字母的宝莱坞歌曲都落进了错误的组。
解决办法是明确的语言提示文件:config/language_hints/ 下的 JSON 配置,列出已知艺术家、标志性关键词和语言代码。放一个带有 "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"] 的 Hindi.json,这些艺术家就会被强制归入印地语组,不管 langdetect 怎么想。流水线在运行时加载这些文件,代码本身没有写死任何语言知识。
接着是艺术家碎片化的问题。初次分拣之后,我有 Akon feat. Eminem、Akon ft Snoop Dogg 和 AKON 的独立文件夹,全是同一位主艺术家,散在三个目录里。整合环节(03A_consolidate_by_artist.py)用了 70% 相似度阈值的模糊匹配,加上一个手工整理的规范名称覆盖表。它完成了 1,365 次文件夹合并,把混乱收敛为 968 个干净的艺术家目录。
最后的结构强制器(03D_titanium_resort.py)给出一个保证:它运行之后,Sorted/ 下的每个文件都遵循 Language/Artist/Album/Artist - Title.ext 层级。不遵循的会被重新分拣或标记。到阶段 3 结束时,曲库已经从 7,246 个文件的扁平堆,变成了没有任何孤儿文件的结构化层级。
阶段 4:丰富,让元数据值钱
把文件分拣进正确的文件夹只完成了一半。另一半是让每个文件能自我描述:正确的 ID3 标签、内嵌封面图、同步歌词。我用了三个外部来源:
- iTunes Search API,提供规范的艺术家名、专辑标题、发行日期和 1000×1000 封面图。无需 API 密钥。脚本在 US 和 GB 两个国家代码之间轮换查询,避开按地区的速率限制。
- LrcLib,提供同步歌词(在播放器里逐词滚动的那种)。免费,无需认证。
- Shazam 的原始识别结果,作为与 iTunes 结果做模糊匹配时的事实锚点。
丰富脚本(04I_polish_and_enrich_v6.py,第六版,这说明了这个过程暴露了多少边缘情况)在写入任何标签之前,会运行一轮 14 种模式的正则去噪。它剥掉垃圾片段:质量标记(128kbps、320kbps、VBR、HQ)、描述残留(official video、full song、dj remix),以及多年来堆积在标签字段里的各种杂音。它通过与 Shazam 的事实锚点做模糊比较,发现颠倒的艺术家/标题字段并自动修正。
结果:目录里 7,160 首中的 6,733 首 现在带有真实的专辑元数据。103 首曲目内嵌了 HD 封面图。25 首有同步歌词。剩下的缺口大多是 iTunes 不收录的地区性曲目,这是一个已知的限制,我记下来,留待以后用 MusicBrainz 再做一轮丰富。
阶段 5–6:定稿与 Spotify 桥接
阶段 5 锁定了目录。05I_finalize_catalog.py 把 ID3、Shazam 和 NLP 分类数据合并成一个 final_catalog.json,一个 1.9 MB 的只读产物,下游使用者把它当作唯一的事实来源。定稿之后:音乐根目录下任何地方都是零个未分拣的音频文件。然后我把它们全删了。30 GB 的音频文件,没了。.data/ 里 11 MB 的流水线状态,也就是目录、丰富记录和 Shazam 识别结果,才是真正重要的东西。目录里的每首歌都在 Spotify 上。本地文件只是原材料;元数据才是产品。
阶段 6 让删除变得毫无痛苦。发现同步引擎(06E_spotify_discovery_sync.py)把目录里的艺术家匹配到 Spotify,并自动生成按流派分类的“Essentials”歌单。首次同步运行时,它处理了 95 位艺术家。创建歌单时 Spotify 返回了 403(应用处于开发模式),导致自动生成的歌单没能落地,这在 Spotify Developer Dashboard 里点一下就能解决,我会在下次运行前处理。
阶段 6 不是真正的回报。回报在于目录已经足够结构化、足够丰富,可以交给 AI,不需要任何音频文件。
阶段 7:AI 技能,按需策划歌单
阶段 1–6 构建了数据集。阶段 7 在它上面放了一个 AI。
我把这个技能以 ultimate-music-manager 的名字发布到了 ClawHub。任何兼容 OpenClaw 的智能体(Claude Code、Codex、Copilot)都可以安装它,并立刻运行流水线或查询目录。技能包里有完整的流水线指令集(SKILL.md)、用于预检和状态面板的辅助脚本,以及一个在破坏性操作执行之前拦截它们的安全钩子。
周末项目的回报就在这里。我现在可以说“给我做一个 90 年代宝莱坞怀旧歌单”,或者“把每一首 Eminem 的曲目按专辑排好给我”,或者“从我的英语收藏里做一个公路旅行混合歌单,摇滚多一点”,而智能体手里真有结构化的元数据来做到:艺术家、标题、专辑、语言、流派。它读取 final_catalog.json,按我用自然语言描述的任何条件过滤,再通过阶段 6 的同步引擎把结果推送到 Spotify。不需要本地音频文件:只要目录和一个 Spotify 订阅。
最终的目录不再是一份扁平的文件名列表。它是一个藏在已发布 AI 技能背后、可查询的数据集,把自然语言变成策划好的歌单,完全由我从自己的音乐中提取的元数据构建,而不是出自一个根本不知道我听什么长大的算法。
取舍
57.6% 的 Shazam 识别率是最大的意外。我本以为声学指纹是银弹:给它音频,得到答案。对主流西方音乐确实如此。对地区性的印度音乐,尤其是老宝莱坞曲目和虔诚歌曲录音,Shazam 的数据库就是没有覆盖。三层兜底(Shazam → ID3 → 文件名)捕获了大多数,但仍有 156 首曲目只靠文件名解析来解决,也就是说它们的元数据只和当初下载的人敲进去的一样好。这 156 条是目录里可信度最低的记录。
丰富脚本的六个版本(从 04A 到 04I)自己就讲了一个故事。每个版本的存在,都是因为上一个在某个我没预料到的边缘情况上崩了:Mutagen 无法保存的混合 ID3v2.3/v2.4 头、iTunes 对模糊查询返回完全不同的曲目、去噪环节不但没修好反而搞得更糟的颠倒艺术家/标题字段。我把每个版本都留在仓库里作为历史记录。按顺序读 04A 到 04I,是理解一个音乐库能朝你扔多少种元数据边缘情况的最快办法。
langdetect 在音译印地语上的失败烧掉了好几个小时。我有 200 多首宝莱坞曲目躺在英语组里,才意识到分类器自信满满地错了。提示文件系统是解法,但它是手工活:得有人为每种语言整理艺术家名单和关键词。对两种语言的收藏(英语和印地语)来说,这还能应付。对 10 种以上语言的多语种曲库,这会是一笔相当可观的前期投入。
不匹配报告里的 690 条,是 iTunes 返回的结果与 Shazam 识别不符的曲目。有些是合理的替代版本(现场录音、重制版)。有些确实是 iTunes 模糊搜索造成的错误匹配。丰富脚本会记录这些,但不会覆盖 Shazam 的事实锚点,这是个保守的选择,偶尔会让某首曲目丰富得不够,而不是给它打错标签。
我学到了什么
我的孩子听到了那些歌。这才是全部目的,它差点淹没在工程里。一堆没有标签的 7,246 个音频文件是数据问题,不是音乐收藏,而数据问题恰恰是 AI 工具已经擅长的领域。我一个周末搭起来的流水线,放在几年前得靠手工分拣好几周。现在目录足够结构化,一个 AI 技能几秒钟就能替我做出歌单,用的是我自己永远没耐心手工整理的元数据。我删掉了 30 GB 的音频,留下 11 MB 的 JSON。文件从来不是目的,数据才是,而数据集会产生复利。
