Sonic Phoenix: devolviendo a la vida 7,246 canciones olvidadas
Esta es una traducción automática del original en inglés. Puede perderse algún matiz, así que la versión en inglés es la referencia. Leer el original en inglés
En resumen
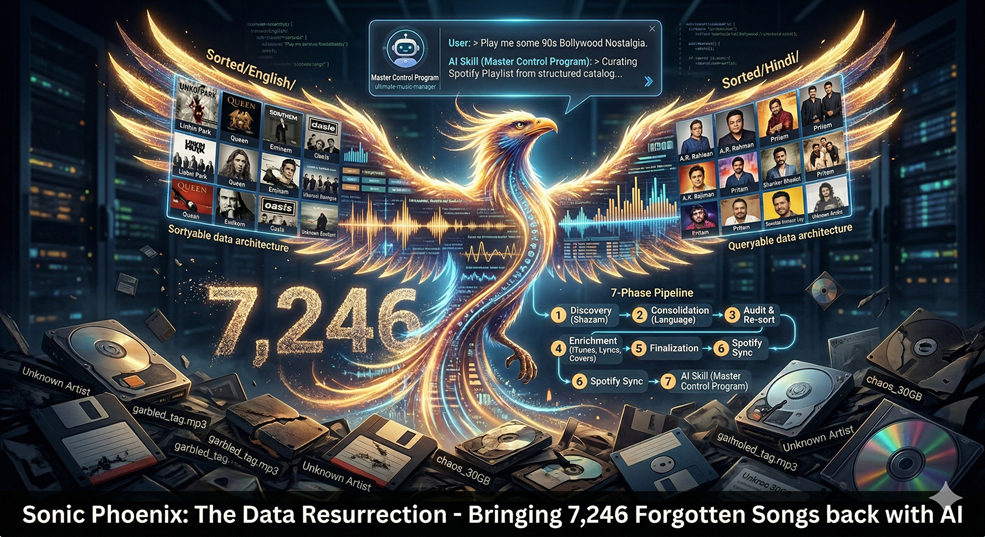
Mi peque me pidió que le pusiera las canciones que yo escuchaba a su edad. Una petición sencilla. Dije que sí, saqué un disco externo cubierto de polvo, lo enchufé y abrí una carpeta que no había tocado en años. Lo que encontré fueron 7,246 archivos de audio con metadatos que estaban mal, ausentes o sin sentido: campos de artista con números de pista, nombres de álbum que no significaban nada, títulos que no tenían nada que ver con la canción real. No podía encontrar ni una sola pista por su nombre. Ese disco guardaba todo con lo que crecí (Eminem, Linkin Park, A.R. Rahman, Pritam, Queen) enterrado bajo capas de etiquetas rotas acumuladas a lo largo de años de copiar, convertir y mover archivos entre dispositivos. El fin de semana que siguió se convirtió en Sonic Phoenix.
La arquitectura
La canalización se divide en siete fases, cada una una serie de scripts pequeños que escriben su estado en disco. Puedes parar tras cualquier fase, inspeccionar el JSON intermedio, arreglar cosas a mano y reanudar sin repetir trabajo. Nada ingenioso: solo una gestión del estado disciplinada que hace abordable un problema caótico.
| Fase | Propósito | Métrica clave |
|---|---|---|
| 1 - Descubrimiento | Huella acústica de cada archivo con Shazam | 7,246 archivos analizados, 4,177 identificados (57.6%) |
| 2 - Consolidación | Catálogo SHA-256 y clasificación de idiomas | 7,160 entradas catalogadas en 2 grupos de idiomas |
| 3 - Auditoría y reordenación | Fusionar artistas fragmentados, imponer estructura | 1,365 movimientos de consolidación, 968 carpetas de artista únicas |
| 4 - Enriquecimiento | Metadatos de iTunes, letras de LrcLib, carátulas | 6,733 pistas con datos reales de álbum |
| 5 - Finalización | Limpiar, compactar y bloquear el catálogo maestro | 0 archivos sin ordenar restantes |
| 6 - Sincronización con Spotify | Reflejar la biblioteca y generar listas automáticamente | 95 artistas sincronizados con el motor de descubrimiento |
| 7 - Habilidad de IA (ClawHub) | Curación de listas bajo demanda con agentes OpenClaw | Publicada como ultimate-music-manager en ClawHub |
La estructura de destino es Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>. De mi colección surgieron dos grupos de idiomas: inglés (3,621 pistas) e hindi (1,410 pistas). La clasificación no está fijada en el código: depende por completo de archivos JSON de sugerencias que dejas en config/language_hints/. Si tu colección es en francés y japonés, la canalización produce Sorted/French/ y Sorted/Japanese/ y nada más.
En su punto álgido, antes de borrar los archivos de audio, la biblioteca ordenada tenía este aspecto:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
La construcción
Fase 1: ignorar todas las etiquetas, fiarse solo del audio
La primera decisión fue la más importante: dejar de confiar en los metadatos existentes. Las etiquetas ID3 de estos archivos no solo estaban incompletas: eran activamente engañosas. Los campos de artista contenían números de pista. Los nombres de álbum eran cadenas sin sentido. Los títulos no se parecían en nada a la canción real. Algunas etiquetas eran correctas, pero no había forma de saber cuáles sin una fuente de verdad externa.
Esa fuente de verdad fue el motor de huellas acústicas de ShazamIO. Pasé cada archivo por él para contrastar lo que afirmaban las etiquetas con lo que era realmente el audio. El script (01D_shazam_all_files.py) ejecuta 20 consultas simultáneas a Shazam, vuelca los resultados a disco cada 100 archivos y es totalmente reanudable: lo maté tres veces durante el fin de semana y cada vez retomó exactamente donde lo había dejado.
De 7,246 archivos, Shazam identificó con certeza 4,177, una tasa de reconocimiento del 57.6%. Donde Shazam confirmaba las etiquetas existentes, se conservaban. Donde discrepaba, ganaba el resultado acústico. Los 3,069 archivos restantes sin reconocer eran una mezcla de pistas oscuras de Bollywood, música regional india y archivos demasiado dañados o demasiado cortos para la coincidencia acústica. Esos pasaron a una resolución en tres niveles: resultado de Shazam → etiquetas ID3 existentes (saneadas y desnormalizadas) → análisis del nombre de archivo como último recurso. El catálogo final muestra el desglose: 6,925 entradas resueltas mediante ID3 (contrastadas o corregidas por Shazam cuando fue posible), 79 solo con Shazam y 156 con el nombre de archivo como alternativa.
Fases 2–3: el problema del idioma y el problema de la fragmentación de artistas
La clasificación de idiomas fue sencilla para las pistas en inglés, pero se vino abajo de inmediato con el hindi. El problema: langdetect ve hindi transliterado (hindi escrito con letras inglesas, “Tujhe Dekha Toh Yeh Jaana Sanam”) y lo clasifica como inglés. Cada canción de Bollywood con título romanizado acabó en el grupo equivocado.
La solución fueron archivos explícitos de sugerencias de idioma: configuraciones JSON en config/language_hints/ que enumeran artistas conocidos, palabras clave características y códigos de idioma. Si dejas un Hindi.json con "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"], esos artistas se enrutan a la fuerza al grupo de hindi, piense lo que piense langdetect. La canalización los cargaba en tiempo de ejecución, sin ningún conocimiento de idiomas fijado en el propio código.
Luego vino el problema de la fragmentación de artistas. Tras la ordenación inicial tenía carpetas separadas para Akon feat. Eminem, Akon ft Snoop Dogg y AKON, todas del mismo artista principal, repartidas en tres directorios. La pasada de consolidación (03A_consolidate_by_artist.py) usó coincidencia difusa con un umbral de similitud del 70% más un mapa manual de excepciones para los nombres canónicos. Ejecutó 1,365 fusiones de carpetas para reducir el desorden a 968 directorios de artista limpios.
El garante estructural final (03D_titanium_resort.py) daba una garantía: después de ejecutarse, cada archivo dentro de Sorted/ cumple la jerarquía Language/Artist/Album/Artist - Title.ext. Todo lo que no la cumple se reordena o se marca. Cuando terminó la fase 3, la biblioteca había pasado de un volcado plano de 7,246 archivos a una jerarquía estructurada sin huérfanos.
Fase 4: enriquecimiento, hacer que los metadatos valgan algo
Ordenar los archivos en las carpetas correctas es la mitad del trabajo. La otra mitad es conseguir que cada archivo se describa a sí mismo: etiquetas ID3 correctas, carátulas incrustadas, letras sincronizadas. Usé tres fuentes externas:
- La API de búsqueda de iTunes para nombres canónicos de artista, títulos de álbum, fechas de lanzamiento y carátulas de 1000×1000. No requiere clave de API. El script rota las consultas entre los códigos de país US y GB para esquivar los límites de peticiones por región.
- LrcLib para letras sincronizadas (las que se desplazan palabra por palabra en un reproductor). Gratis, sin autenticación.
- La identificación original de Shazam como ancla de verdad para la coincidencia difusa con los resultados de iTunes.
El script de enriquecimiento (04I_polish_and_enrich_v6.py, la sexta iteración, lo que te dice cuántos casos límite sacó a la luz este proceso) ejecuta una pasada de limpieza con 14 patrones de expresiones regulares antes de escribir ninguna etiqueta. Elimina fragmentos basura: marcadores de calidad (128kbps, 320kbps, VBR, HQ), restos descriptivos (official video, full song, dj remix) y ruido diverso acumulado en los campos de etiqueta durante años. Detecta campos de artista y título invertidos comparándolos de forma difusa con la verdad de Shazam y los corrige automáticamente.
El resultado: 6,733 de 7,160 pistas catalogadas llevan ahora metadatos reales de álbum. 103 pistas tienen carátulas HD incrustadas. 25 tienen letras sincronizadas. Los huecos restantes son en su mayoría pistas regionales que iTunes no indexa, una limitación conocida que estoy siguiendo para una futura pasada de enriquecimiento con MusicBrainz.
Fases 5–6: la finalización y el puente con Spotify
La fase 5 bloqueó el catálogo. 05I_finalize_catalog.py fusiona los datos de ID3, Shazam y clasificación PLN en un único final_catalog.json, un artefacto de solo lectura de 1.9 MB que los consumidores posteriores tratan como la única fuente de verdad. Tras la finalización: cero archivos de audio sin ordenar en toda la raíz de música. Y entonces los borré todos. 30 GB de archivos de audio, desaparecidos. Los 11 MB de estado de la canalización en .data/, los catálogos, los registros de enriquecimiento, las identificaciones de Shazam, eso es lo que realmente importa. Cada canción del catálogo existe en Spotify. Los archivos locales eran solo la materia prima; los metadatos son el producto.
La fase 6 hizo indolora la eliminación. El motor de sincronización de descubrimiento (06E_spotify_discovery_sync.py) contrasta los artistas del catálogo con Spotify y genera automáticamente listas “Essentials” por género. Procesó 95 artistas en la primera ejecución de sincronización. El error 403 de Spotify al crear listas (la aplicación estaba en modo de desarrollo) impidió que las listas generadas automáticamente llegaran a existir, algo que se arregla con un clic en el panel de desarrolladores de Spotify y que resolveré antes de la próxima ejecución.
La fase 6 no es la recompensa. La recompensa es que el catálogo está lo bastante estructurado y enriquecido como para entregárselo a una IA, sin necesitar archivos de audio.
Fase 7: la habilidad de IA, curación de listas bajo demanda
Las fases 1–6 construyeron el conjunto de datos. La fase 7 pone una IA encima.
He publicado la habilidad en ClawHub con el nombre ultimate-music-manager. Cualquier agente compatible con OpenClaw (Claude Code, Codex, Copilot) puede instalarla y operar de inmediato la canalización o consultar el catálogo. El paquete de la habilidad incluye el conjunto completo de instrucciones de la canalización (SKILL.md), scripts auxiliares para comprobaciones previas y paneles de estado, y un hook de seguridad que intercepta las operaciones destructivas antes de que se ejecuten.
Aquí es donde el proyecto de fin de semana da sus frutos. Ahora puedo decir “hazme una lista de nostalgia de Bollywood de los 90” o “dame todas las pistas de Eminem ordenadas por álbum” o “crea una mezcla de viaje por carretera de mi colección en inglés, con mucho rock” y el agente tiene los metadatos estructurados (artista, título, álbum, idioma, género) para hacerlo de verdad. Lee final_catalog.json, filtra según los criterios que describo en lenguaje natural y envía el resultado a Spotify mediante el motor de sincronización de la fase 6. No hacen falta archivos de audio locales: solo el catálogo y una suscripción a Spotify.
El catálogo final ya no es una lista plana de nombres de archivo. Es un conjunto de datos consultable detrás de una habilidad de IA publicada que convierte el lenguaje natural en listas curadas, construido por completo a partir de metadatos que extraje de mi propia música, no de un algoritmo que no sabe con qué crecí.
Las contrapartidas
La tasa de reconocimiento de Shazam del 57.6% fue la mayor sorpresa. Esperaba que las huellas acústicas fueran una bala de plata: das audio, recibes una respuesta. Para la música occidental convencional lo fue. Para la música regional india, sobre todo las pistas antiguas de Bollywood y las grabaciones devocionales, la base de datos de Shazam sencillamente no tenía cobertura. La alternativa en tres niveles (Shazam → ID3 → nombre de archivo) atrapó la mayoría, pero 156 pistas siguieron resolviéndose solo mediante el análisis del nombre de archivo, lo que significa que sus metadatos valen tanto como lo que escribiera quien las descargó. Esas 156 entradas son los registros de menor confianza del catálogo.
Las seis iteraciones del script de enriquecimiento (de 04A a 04I) cuentan su propia historia. Cada versión existe porque la anterior falló con un caso límite que no había previsto: cabeceras ID3v2.3/v2.4 mezcladas que Mutagen no podía guardar, iTunes devolviendo una pista completamente distinta para una consulta difusa, campos de artista y título invertidos que la pasada de limpieza empeoraba en lugar de mejorar. Conservé cada iteración en el repositorio como registro histórico. Leer de 04A a 04I en orden es la forma más rápida de entender todos los casos límite de metadatos que puede lanzarte una biblioteca de música.
El fallo de langdetect con el hindi transliterado me costó horas. Tenía más de 200 pistas de Bollywood en el grupo de inglés antes de darme cuenta de que el clasificador se equivocaba con total seguridad. El sistema de archivos de sugerencias fue la solución, pero es un proceso manual: alguien tiene que curar esas listas de artistas y palabras clave por idioma. Para una colección de dos idiomas (inglés e hindi) fue manejable. Para una biblioteca políglota con más de 10 idiomas sería una inversión inicial considerable.
Las 690 entradas del informe de discrepancias representan pistas en las que iTunes devolvió un resultado que no coincidía con la identificación de Shazam. Algunas eran versiones alternativas legítimas (grabaciones en directo, remasterizaciones). Otras eran coincidencias realmente erróneas de la búsqueda difusa de iTunes. El script de enriquecimiento las registra, pero no anula la verdad de Shazam: una elección conservadora que de vez en cuando deja una pista poco enriquecida en lugar de mal etiquetada.
Lo que aprendí
Mi peque pudo escuchar las canciones. Ese era todo el sentido, y casi se perdió entre la ingeniería. Un montón de 7,246 archivos de audio sin etiquetar es un problema de datos, no una colección musical, y los problemas de datos son exactamente en lo que las herramientas de IA se han vuelto buenas. La canalización que construí en un fin de semana habría llevado semanas de ordenación manual hace unos años. Ahora el catálogo está lo bastante estructurado como para que una habilidad de IA me arme una lista en segundos a partir de metadatos que nunca habría tenido la paciencia de curar a mano. Borré 30 GB de audio y conservé 11 MB de JSON. Los archivos nunca fueron el objetivo: lo fueron los datos, y los conjuntos de datos se acumulan.

Escrito por
Rohit BuraniIngeniería de IA: sistemas local-first, infraestructura autoalojada y herramientas autónomas desde el laboratorio.