Sonic Phoenix: 7,246 भूले-बिसरे गानों को मौत से वापस लाना
यह अंग्रेज़ी मूल लेख का मशीनी अनुवाद है। कुछ बारीकियाँ छूट सकती हैं, इसलिए संदर्भ के लिए अंग्रेज़ी संस्करण ही मान्य है। अंग्रेज़ी में मूल लेख पढ़ें
संक्षेप में
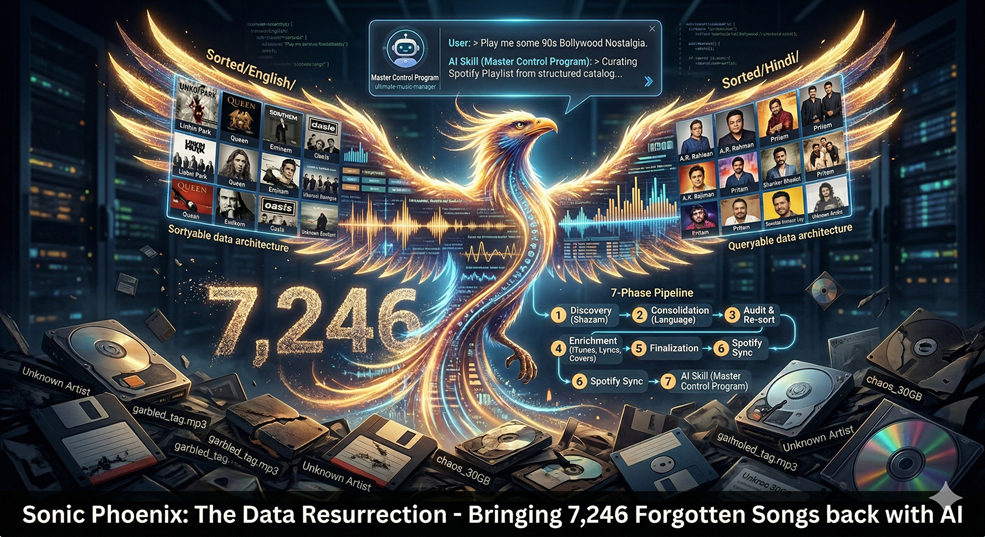
मेरे बच्चे ने मुझसे वे गाने बजाने को कहा जो मैं उसकी उम्र में सुना करता था। सीधी-सी फ़रमाइश। मैंने हाँ कहा, धूल जमी एक एक्सटर्नल ड्राइव निकाली, उसे लगाया और एक ऐसा फ़ोल्डर खोला जिसे मैंने सालों से नहीं छुआ था। जो मिला वह था 7,246 ऑडियो फ़ाइलें, जिनका मेटाडेटा या तो ग़लत था, या ग़ायब था, या बेतुका: आर्टिस्ट फ़ील्ड में ट्रैक नंबर, एलबम के ऐसे नाम जिनका कोई मतलब नहीं, शीर्षक जिनका असली गाने से कोई लेना-देना नहीं। मैं एक भी ट्रैक नाम से नहीं ढूँढ पाया। उस ड्राइव में वह सब था जिस पर मैं बड़ा हुआ (Eminem, Linkin Park, A.R. Rahman, Pritam, Queen), सालों तक रिप करने, कन्वर्ट करने और उपकरणों के बीच फ़ाइलें घुमाने में जमा हुए टूटे टैग की परतों के नीचे दबा हुआ। उसके बाद का वीकेंड Sonic Phoenix बन गया।
आर्किटेक्चर
पाइपलाइन सात चरणों में बँटी है, हर चरण छोटी स्क्रिप्टों की एक श्रृंखला जो अपनी स्थिति डिस्क पर लिखती है। आप किसी भी चरण के बाद रुक सकते हैं, बीच का JSON जाँच सकते हैं, चीज़ें हाथ से ठीक कर सकते हैं, और काम दोहराए बिना दोबारा शुरू कर सकते हैं। इसमें कुछ चतुराई नहीं है, बस अनुशासित स्टेट मैनेजमेंट जो अस्त-व्यस्त समस्या को सुलझने-लायक़ बना देता है।
| चरण | उद्देश्य | मुख्य मीट्रिक |
|---|---|---|
| 1 - खोज | Shazam से हर फ़ाइल की एकॉस्टिक फ़िंगरप्रिंटिंग | 7,246 फ़ाइलें स्कैन हुईं, 4,177 पहचानी गईं (57.6%) |
| 2 - समेकन | SHA-256 कैटलॉग और भाषा वर्गीकरण | 2 भाषा-समूहों में 7,160 कैटलॉग प्रविष्टियाँ |
| 3 - ऑडिट और पुनः-छँटाई | बिखरे आर्टिस्ट मिलाना, संरचना लागू करना | 1,365 समेकन चालें, 968 अनूठे आर्टिस्ट फ़ोल्डर |
| 4 - संवर्धन | iTunes मेटाडेटा, LrcLib के बोल, कवर आर्ट | 6,733 ट्रैक असली एलबम डेटा के साथ |
| 5 - अंतिम रूप | साफ़ करना, समेटना, मास्टर कैटलॉग लॉक करना | 0 बिना छँटी फ़ाइलें शेष |
| 6 - Spotify सिंक | लाइब्रेरी का प्रतिबिंब और प्लेलिस्ट अपने आप बनाना | 95 आर्टिस्ट डिस्कवरी इंजन से सिंक हुए |
| 7 - AI स्किल (ClawHub) | OpenClaw एजेंट से माँग पर प्लेलिस्ट क्यूरेशन | ClawHub पर ultimate-music-manager के रूप में जारी |
लक्ष्य संरचना है Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>। मेरे संग्रह से दो भाषा-समूह उभरे: अंग्रेज़ी (3,621 ट्रैक) और हिंदी (1,410 ट्रैक)। वर्गीकरण कोड में हार्डकोड नहीं है: वह पूरी तरह उन JSON संकेत-फ़ाइलों से चलता है जो आप config/language_hints/ में डालते हैं। अगर आपका संग्रह फ़्रेंच और जापानी का है, तो पाइपलाइन Sorted/French/ और Sorted/Japanese/ बनाती है, और कुछ नहीं।
अपने चरम पर, ऑडियो फ़ाइलें हटाने से पहले, छँटी हुई लाइब्रेरी ऐसी दिखती थी:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
निर्माण
चरण 1: हर टैग को अनदेखा करें, सिर्फ़ ऑडियो पर भरोसा करें
पहला फ़ैसला सबसे अहम था: मौजूदा मेटाडेटा पर भरोसा करना बंद करना। इन फ़ाइलों के ID3 टैग सिर्फ़ अधूरे नहीं थे, वे सक्रिय रूप से भ्रामक थे। आर्टिस्ट फ़ील्ड में ट्रैक नंबर थे। एलबम के नाम बेमतलब स्ट्रिंग थे। शीर्षकों का असली गाने से कोई मेल नहीं था। कुछ टैग सही थे, लेकिन बाहरी सत्य-स्रोत के बिना यह जानने का कोई तरीक़ा नहीं था कि कौन-से।
वह सत्य-स्रोत ShazamIO का एकॉस्टिक फ़िंगरप्रिंटिंग इंजन था। मैंने हर फ़ाइल उसमें डाली ताकि टैग जो दावा करते थे उसे ऑडियो असल में जो था उससे मिलाकर जाँचा जा सके। स्क्रिप्ट (01D_shazam_all_files.py) 20 समवर्ती Shazam लुकअप चलाती है, हर 100 फ़ाइलों पर नतीजे डिस्क पर लिखती है, और पूरी तरह दोबारा शुरू होने लायक़ है: मैंने वीकेंड में उसे तीन बार रोका और हर बार वह ठीक वहीं से चली जहाँ छोड़ी थी।
7,246 फ़ाइलों में से Shazam ने 4,177 को पक्के तौर पर पहचाना, यानी 57.6% पहचान दर। जहाँ Shazam ने मौजूदा टैग की पुष्टि की, वे रखे गए। जहाँ वह असहमत था, एकॉस्टिक नतीजा जीता। बाक़ी 3,069 अपहचानी फ़ाइलें अस्पष्ट Bollywood ट्रैक, क्षेत्रीय भारतीय संगीत, और एकॉस्टिक मिलान के लिए बहुत ख़राब या बहुत छोटी फ़ाइलों का मिश्रण थीं। वे तीन-स्तरीय समाधान में गईं: Shazam का नतीजा → मौजूदा ID3 टैग (साफ़ किए और अ-सामान्यीकृत) → आख़िरी उपाय के रूप में फ़ाइल-नाम का विश्लेषण। अंतिम कैटलॉग ब्योरा दिखाता है: 6,925 प्रविष्टियाँ ID3 से हल हुईं (जहाँ संभव हुआ Shazam से पुष्ट या सुधारी गईं), 79 पूरी तरह Shazam से, और 156 फ़ाइल-नाम के विकल्प से।
चरण 2–3: भाषा की समस्या और आर्टिस्ट के बिखराव की समस्या
अंग्रेज़ी ट्रैक के लिए भाषा वर्गीकरण सीधा था, लेकिन हिंदी पर वह तुरंत बिखर गया। समस्या: langdetect लिप्यंतरित हिंदी (अंग्रेज़ी अक्षरों में लिखी हिंदी, “Tujhe Dekha Toh Yeh Jaana Sanam”) देखता है और उसे अंग्रेज़ी बता देता है। हर रोमन शीर्षक वाला Bollywood गाना ग़लत समूह में पहुँच गया।
हल था स्पष्ट भाषा-संकेत फ़ाइलें: config/language_hints/ के तहत JSON कॉन्फ़िग जिनमें जाने-पहचाने आर्टिस्ट, ख़ास कीवर्ड और भाषा कोड दर्ज हैं। "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"] वाली एक Hindi.json डाल दीजिए, तो वे आर्टिस्ट ज़बरदस्ती हिंदी समूह में भेजे जाते हैं, चाहे langdetect कुछ भी सोचे। पाइपलाइन इन्हें रनटाइम पर लोड करती थी, कोड में भाषा का कोई हार्डकोड ज्ञान रखे बिना।
फिर आया आर्टिस्ट के बिखराव का मसला। शुरुआती छँटाई के बाद मेरे पास Akon feat. Eminem, Akon ft Snoop Dogg और AKON के अलग फ़ोल्डर थे, सब एक ही मुख्य आर्टिस्ट के, तीन डायरेक्टरी में बिखरे। समेकन पास (03A_consolidate_by_artist.py) ने 70% समानता की सीमा पर फ़ज़ी मैचिंग और मानक नामों के लिए हाथ से बने ओवरराइड मैप का इस्तेमाल किया। उसने 1,365 फ़ोल्डर विलय किए ताकि गड़बड़ी घटकर 968 साफ़ आर्टिस्ट डायरेक्टरी रह जाए।
अंतिम संरचनात्मक प्रवर्तक (03D_titanium_resort.py) ने एक गारंटी दी: उसके चलने के बाद Sorted/ के नीचे की हर फ़ाइल Language/Artist/Album/Artist - Title.ext पदानुक्रम का पालन करती है। जो नहीं करती वह दोबारा छाँटी जाती है या चिह्नित होती है। चरण 3 ख़त्म होने तक लाइब्रेरी 7,246 फ़ाइलों के सपाट ढेर से बिना किसी अनाथ फ़ाइल वाले संरचित पदानुक्रम में बदल चुकी थी।
चरण 4: संवर्धन, मेटाडेटा को कुछ क़ीमती बनाना
फ़ाइलों को सही फ़ोल्डर में छाँटना आधा काम है। बाक़ी आधा हर फ़ाइल को ख़ुद का परिचय देने लायक़ बनाना है: सही ID3 टैग, एम्बेड किया कवर आर्ट, सिंक्रोनाइज़्ड बोल। मैंने तीन बाहरी स्रोत इस्तेमाल किए:
- iTunes Search API मानक आर्टिस्ट नाम, एलबम शीर्षक, रिलीज़ तारीख़ और 1000×1000 कवर आर्ट के लिए। इसमें API कुंजी नहीं चाहिए। स्क्रिप्ट प्रति-क्षेत्र दर-सीमा से बचने के लिए US और GB देश कोड के बीच क्वेरी घुमाती है।
- LrcLib सिंक्रोनाइज़्ड बोल के लिए (वे जो प्लेयर में शब्द-दर-शब्द स्क्रॉल होते हैं)। मुफ़्त, बिना ऑथ।
- Shazam की मूल पहचान iTunes नतीजों से फ़ज़ी मिलान के लिए सत्य-आधार के रूप में।
संवर्धन स्क्रिप्ट (04I_polish_and_enrich_v6.py, छठा संस्करण, जो बताता है कि इस प्रक्रिया ने कितने किनारे के मामले उजागर किए) कोई भी टैग लिखने से पहले 14-पैटर्न रेगेक्स डीनॉइज़ पास चलाती है। वह कचरा टुकड़े हटाती है: गुणवत्ता चिह्न (128kbps, 320kbps, VBR, HQ), वर्णन के अवशेष (official video, full song, dj remix), और सालों में टैग फ़ील्ड में जमा हुआ तरह-तरह का शोर। वह Shazam के सत्य-आधार से फ़ज़ी तुलना करके उलटे आर्टिस्ट/शीर्षक फ़ील्ड पकड़ती है और अपने आप सुधार देती है।
नतीजा: कैटलॉग के 7,160 में से 6,733 ट्रैक अब असली एलबम मेटाडेटा रखते हैं। 103 ट्रैक में एम्बेडेड HD कवर आर्ट है। 25 में सिंक्रोनाइज़्ड बोल हैं। बाक़ी कमियाँ ज़्यादातर क्षेत्रीय ट्रैक की हैं जिन्हें iTunes इंडेक्स नहीं करता, एक ज्ञात सीमा जिसे मैं MusicBrainz के विरुद्ध भविष्य के संवर्धन पास के लिए नोट कर रहा हूँ।
चरण 5–6: अंतिम रूप और Spotify का पुल
चरण 5 ने कैटलॉग लॉक कर दिया। 05I_finalize_catalog.py ID3, Shazam और NLP वर्गीकरण डेटा को एक अकेले final_catalog.json में मिलाती है, 1.9 MB की रीड-ओनली फ़ाइल जिसे आगे के उपभोक्ता इकलौता सत्य-स्रोत मानते हैं। अंतिम रूप के बाद: संगीत की जड़ में कहीं भी शून्य बिना छँटी ऑडियो फ़ाइलें। और फिर मैंने उन सबको हटा दिया। 30 GB की ऑडियो फ़ाइलें, ग़ायब। .data/ में पाइपलाइन स्टेट के 11 MB, यानी कैटलॉग, संवर्धन रिकॉर्ड, Shazam की पहचानें, असल में वही मायने रखता है। कैटलॉग का हर गाना Spotify पर है। स्थानीय फ़ाइलें बस कच्चा माल थीं; मेटाडेटा उत्पाद है।
चरण 6 ने हटाना बिना दर्द का बना दिया। डिस्कवरी सिंक इंजन (06E_spotify_discovery_sync.py) कैटलॉग के आर्टिस्ट को Spotify से मिलाता है और शैली-आधारित “Essentials” प्लेलिस्ट अपने आप बनाता है। पहली सिंक रन में उसने 95 आर्टिस्ट प्रोसेस किए। प्लेलिस्ट बनाने पर Spotify का 403 (ऐप डेवलपमेंट मोड में था) अपने आप बनी प्लेलिस्टों को उतरने से रोक गया, जो Spotify Developer Dashboard में एक क्लिक से ठीक हो जाता है और जिसे मैं अगली रन से पहले हल कर लूँगा।
चरण 6 इनाम नहीं है। इनाम यह है कि कैटलॉग इतना संरचित और समृद्ध है कि उसे AI को सौंपा जा सकता है, ऑडियो फ़ाइलों के बिना।
चरण 7: AI स्किल, माँग पर प्लेलिस्ट क्यूरेशन
चरण 1–6 ने डेटासेट बनाया। चरण 7 उसके ऊपर एक AI बिठाता है।
मैंने स्किल को ClawHub पर ultimate-music-manager नाम से जारी किया है। कोई भी OpenClaw-संगत एजेंट (Claude Code, Codex, Copilot) उसे इंस्टॉल करके तुरंत पाइपलाइन चला सकता है या कैटलॉग से सवाल पूछ सकता है। स्किल पैकेज में पाइपलाइन के निर्देशों का पूरा सेट (SKILL.md), प्रीफ़्लाइट जाँच और स्टेटस डैशबोर्ड के लिए सहायक स्क्रिप्टें, और एक सुरक्षा हुक है जो विनाशकारी क्रियाओं को चलने से पहले रोक लेता है।
यहीं वीकेंड प्रोजेक्ट का फल मिलता है। अब मैं कह सकता हूँ “मेरे लिए 90 के दशक की Bollywood नॉस्टैल्जिया प्लेलिस्ट बनाओ” या “मुझे हर Eminem ट्रैक एलबम के हिसाब से छाँटकर दो” या “मेरे अंग्रेज़ी संग्रह से रोड ट्रिप मिक्स बनाओ, ज़्यादातर रॉक” और एजेंट के पास असल में यह करने के लिए संरचित मेटाडेटा है: आर्टिस्ट, शीर्षक, एलबम, भाषा, शैली। वह final_catalog.json पढ़ता है, मैं जिस भी मापदंड का सरल भाषा में वर्णन करूँ उससे छाँटता है, और नतीजा चरण 6 के सिंक इंजन से Spotify तक पहुँचा देता है। स्थानीय ऑडियो फ़ाइलों की ज़रूरत नहीं: बस कैटलॉग और एक Spotify सब्सक्रिप्शन।
अंतिम कैटलॉग अब फ़ाइल-नामों की सपाट सूची नहीं है। वह एक जारी की गई AI स्किल के पीछे बैठा खोजने-योग्य डेटासेट है जो प्राकृतिक भाषा को क्यूरेट की गई प्लेलिस्ट में बदल देता है, जो पूरी तरह मेरे अपने संगीत से निकाले गए मेटाडेटा से बना है, किसी ऐसे एल्गोरिद्म से नहीं जिसे यह पता ही नहीं कि मैं किस पर बड़ा हुआ।
समझौते
57.6% Shazam पहचान दर सबसे बड़ी हैरानी थी। मुझे उम्मीद थी कि एकॉस्टिक फ़िंगरप्रिंटिंग रामबाण होगी: ऑडियो दो, जवाब पाओ। मुख्यधारा के पश्चिमी संगीत के लिए वह थी। क्षेत्रीय भारतीय संगीत के लिए, ख़ासकर पुराने Bollywood ट्रैक और भक्ति रिकॉर्डिंग के लिए, Shazam के डेटाबेस में बस कवरेज नहीं थी। तीन-स्तरीय विकल्प (Shazam → ID3 → फ़ाइल-नाम) ने ज़्यादातर पकड़ लिए, लेकिन 156 ट्रैक फिर भी सिर्फ़ फ़ाइल-नाम विश्लेषण से हल हुए, यानी उनका मेटाडेटा उतना ही अच्छा है जितना मूल डाउनलोड करने वाले ने टाइप किया था। ये 156 प्रविष्टियाँ कैटलॉग के सबसे कम भरोसे वाले रिकॉर्ड हैं।
संवर्धन स्क्रिप्ट के छह संस्करण (04A से 04I तक) अपनी कहानी ख़ुद कहते हैं। हर संस्करण इसलिए है क्योंकि पिछला किसी ऐसे किनारे के मामले पर टूटा जिसका मैंने अनुमान नहीं लगाया था: मिले-जुले ID3v2.3/v2.4 हेडर जिन्हें Mutagen सेव नहीं कर सका, iTunes का फ़ज़ी क्वेरी के लिए बिल्कुल अलग ट्रैक लौटाना, उलटे आर्टिस्ट/शीर्षक फ़ील्ड जिन्हें डीनॉइज़ पास ने बेहतर करने के बजाय और बिगाड़ दिया। मैंने हर संस्करण ऐतिहासिक रिकॉर्ड के रूप में रेपो में रखा है। 04A से 04I तक क्रम से पढ़ना यह समझने का सबसे तेज़ तरीक़ा है कि संगीत लाइब्रेरी आप पर कितने तरह के मेटाडेटा किनारे के मामले फेंक सकती है।
लिप्यंतरित हिंदी पर langdetect की विफलता ने घंटों जलाए। मेरे पास 200 से ज़्यादा Bollywood ट्रैक अंग्रेज़ी समूह में पड़े थे, तब जाकर समझ आया कि वर्गीकारक पूरे आत्मविश्वास से ग़लत है। संकेत-फ़ाइल प्रणाली हल थी, लेकिन यह हाथ का काम है: किसी को हर भाषा के लिए आर्टिस्ट सूची और कीवर्ड तैयार करने पड़ते हैं। दो भाषाओं के संग्रह (अंग्रेज़ी और हिंदी) के लिए यह सँभालने लायक़ था। 10 से ज़्यादा भाषाओं वाली बहुभाषी लाइब्रेरी के लिए यह काफ़ी बड़ा शुरुआती निवेश होगा।
बेमेल रिपोर्ट की 690 प्रविष्टियाँ उन ट्रैक की हैं जहाँ iTunes ने ऐसा नतीजा लौटाया जो Shazam की पहचान से मेल नहीं खाता था। कुछ वैध वैकल्पिक संस्करण थे (लाइव रिकॉर्डिंग, रीमास्टर)। कुछ iTunes की फ़ज़ी खोज से सचमुच ग़लत मिलान थे। संवर्धन स्क्रिप्ट इन्हें लॉग करती है लेकिन Shazam के सत्य-आधार को ओवरराइड नहीं करती, एक सतर्क चुनाव जो कभी-कभार किसी ट्रैक को ग़लत टैग करने के बजाय कम समृद्ध छोड़ देता है।
मैंने क्या सीखा
मेरे बच्चे ने गाने सुन लिए। पूरा मक़सद वही था, और वह इंजीनियरिंग में लगभग खो गया। 7,246 बिना टैग वाली ऑडियो फ़ाइलों का ढेर डेटा की समस्या है, संगीत का संग्रह नहीं, और डेटा की समस्याएँ ठीक वही हैं जिनमें AI टूलिंग अच्छी हो चुकी है। जो पाइपलाइन मैंने एक वीकेंड में बनाई, वह कुछ साल पहले हफ़्तों की हाथ की छँटाई माँगती। अब कैटलॉग इतना संरचित है कि एक AI स्किल सेकंडों में मेरे लिए प्लेलिस्ट बना देती है, उस मेटाडेटा से जिसे हाथ से सँवारने का धैर्य मुझमें कभी नहीं होता। मैंने 30 GB ऑडियो हटाया और 11 MB JSON रखा। फ़ाइलें कभी मक़सद नहीं थीं, डेटा था, और डेटासेट चक्रवृद्धि होते हैं।

लेखक
Rohit BuraniAI इंजीनियर, जो लैब से लोकल-फ़र्स्ट सिस्टम, सेल्फ़-होस्टेड इंफ्रास्ट्रक्चर और स्वायत्त टूल बनाते हैं।