Sonic Phoenix: మరిచిపోయిన 7,246 పాటలను మరణం నుంచి వెనక్కి తీసుకురావడం
ఇది ఆంగ్ల మూల వ్యాసానికి యంత్ర అనువాదం. కొన్ని సూక్ష్మ భేదాలు కోల్పోవచ్చు, కాబట్టి ఆంగ్ల వెర్షన్నే ప్రమాణంగా తీసుకోండి. మూల వ్యాసాన్ని ఆంగ్లంలో చదవండి
సంక్షిప్తంగా
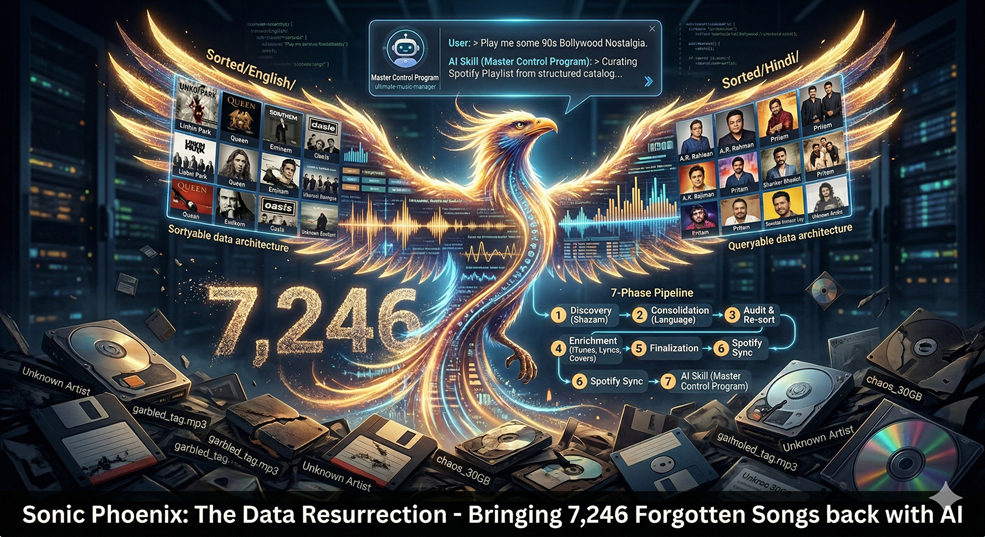
నా బిడ్డ నన్ను అడిగిన కోరిక ఇది: నేను తన వయసులో వినే పాటలు పెట్టమని. సరళమైన కోరిక. సరే అన్నాను, దుమ్ము పట్టిన ఒక ఎక్స్టర్నల్ డ్రైవ్ తీసి, కనెక్ట్ చేసి, ఏళ్లుగా ముట్టుకోని ఫోల్డర్ తెరిచాను. దొరికింది 7,246 ఆడియో ఫైళ్లు, వాటి మెటాడేటా తప్పు, లేదా లేదు, లేదా అర్థం లేనిది: కళాకారుడి ఫీల్డ్లో ట్రాక్ నంబర్లు, అర్థం లేని ఆల్బమ్ పేర్లు, అసలు పాటకు ఏ సంబంధమూ లేని శీర్షికలు. ఒక్క ట్రాక్ను కూడా పేరుతో వెతికి పట్టుకోలేకపోయాను. ఆ డ్రైవ్లో నేను పెరిగిన ప్రతిదీ ఉంది (Eminem, Linkin Park, A.R. Rahman, Pritam, Queen), ఏళ్ల తరబడి రిప్ చేయడం, కన్వర్ట్ చేయడం, పరికరాల మధ్య ఫైళ్లు తిప్పడం వల్ల పేరుకుపోయిన విరిగిన ట్యాగ్ల పొరల కింద పూడ్చబడి. ఆ తర్వాతి వారాంతం Sonic Phoenix అయింది.
ఆర్కిటెక్చర్
పైప్లైన్ ఏడు దశలుగా విభజించబడింది, ప్రతి దశ తన స్థితిని డిస్క్లో రాసే చిన్న స్క్రిప్ట్ల శ్రేణి. మీరు ఏ దశ తర్వాతైనా ఆగవచ్చు, మధ్యలోని JSONను పరిశీలించవచ్చు, చేత్తో సరిదిద్దవచ్చు, పని మళ్లీ చేయకుండా తిరిగి ప్రారంభించవచ్చు. ఇందులో తెలివి ఏమీ లేదు, గందరగోళ సమస్యను పరిష్కరించదగినదిగా చేసే క్రమశిక్షణతో కూడిన స్టేట్ మేనేజ్మెంట్ మాత్రమే.
| దశ | ఉద్దేశ్యం | ముఖ్య కొలమానం |
|---|---|---|
| 1 - అన్వేషణ | Shazamతో ప్రతి ఫైల్ ధ్వని ఫింగర్ప్రింట్ | 7,246 ఫైళ్లు స్కాన్ అయ్యాయి, 4,177 గుర్తించబడ్డాయి (57.6%) |
| 2 - ఏకీకరణ | SHA-256 కేటలాగ్, భాష వర్గీకరణ | 2 భాషా సమూహాల్లో 7,160 కేటలాగ్ ఎంట్రీలు |
| 3 - ఆడిట్, పునర్వర్గీకరణ | చెల్లాచెదురైన కళాకారులను కలపడం, నిర్మాణాన్ని అమలు చేయడం | 1,365 ఏకీకరణ కదలికలు, 968 ప్రత్యేక కళాకారుల ఫోల్డర్లు |
| 4 - సమృద్ధీకరణ | iTunes మెటాడేటా, LrcLib సాహిత్యం, కవర్ ఆర్ట్ | 6,733 ట్రాక్లకు నిజమైన ఆల్బమ్ డేటా |
| 5 - తుది రూపం | శుభ్రం చేయడం, కుదించడం, మాస్టర్ కేటలాగ్ లాక్ | 0 వర్గీకరించని ఫైళ్లు మిగిలాయి |
| 6 - Spotify సింక్ | లైబ్రరీ ప్రతిబింబం, ప్లేలిస్ట్ల స్వయంచాలక సృష్టి | 95 మంది కళాకారులు డిస్కవరీ ఇంజిన్కు సింక్ అయ్యారు |
| 7 - AI స్కిల్ (ClawHub) | OpenClaw ఏజెంట్ల ద్వారా అడిగినప్పుడల్లా ప్లేలిస్ట్ క్యూరేషన్ | ClawHubలో ultimate-music-manager పేరుతో విడుదలైంది |
లక్ష్య నిర్మాణం Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>. నా సేకరణ నుంచి రెండు భాషా సమూహాలు బయటపడ్డాయి: ఇంగ్లీష్ (3,621 ట్రాక్లు), హిందీ (1,410 ట్రాక్లు). వర్గీకరణ కోడ్లో హార్డ్కోడ్ కాలేదు, అది పూర్తిగా మీరు config/language_hints/లో ఉంచే JSON సూచన ఫైళ్లతో నడుస్తుంది. మీ సేకరణ ఫ్రెంచ్, జపనీస్ అయితే, పైప్లైన్ Sorted/French/, Sorted/Japanese/ సృష్టిస్తుంది, ఇంకేమీ కాదు.
ఉచ్ఛస్థితిలో, ఆడియో ఫైళ్లను తొలగించే ముందు, వర్గీకరించిన లైబ్రరీ ఇలా కనిపించేది:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
నిర్మాణం
దశ 1: ప్రతి ట్యాగ్ను విస్మరించండి, ఆడియోను మాత్రమే నమ్మండి
మొదటి నిర్ణయమే అత్యంత ముఖ్యమైనది: ఉన్న మెటాడేటాను నమ్మడం ఆపడం. ఈ ఫైళ్లలోని ID3 ట్యాగ్లు అసంపూర్ణమైనవి మాత్రమే కాదు, చురుకుగా తప్పుదారి పట్టించేవి. కళాకారుడి ఫీల్డ్లలో ట్రాక్ నంబర్లు ఉన్నాయి. ఆల్బమ్ పేర్లు అర్థం లేని స్ట్రింగ్లు. శీర్షికలు అసలు పాటను పోలి లేవు. కొన్ని ట్యాగ్లు సరైనవే, కానీ బయటి సత్య మూలం లేకుండా ఏవో తెలుసుకునే మార్గం లేదు.
ఆ సత్య మూలం ShazamIO ధ్వని ఫింగర్ప్రింటింగ్ ఇంజిన్. ట్యాగ్లు చెప్పేదానినీ, ఆడియో నిజానికి ఏమిటో దానినీ సరిపోల్చడానికి ప్రతి ఫైల్ను దాని గుండా పంపాను. స్క్రిప్ట్ (01D_shazam_all_files.py) 20 సమాంతర Shazam లుకప్లు నడుపుతుంది, ప్రతి 100 ఫైళ్లకు ఫలితాలను డిస్క్కు రాస్తుంది, పూర్తిగా తిరిగి ప్రారంభించదగినది: వారాంతంలో దాన్ని మూడుసార్లు ఆపాను, ప్రతిసారీ ఆగిన చోటి నుంచే మళ్లీ మొదలైంది.
7,246 ఫైళ్లలో Shazam 4,177 ఫైళ్లను కచ్చితంగా గుర్తించింది, అంటే 57.6% గుర్తింపు రేటు. Shazam ఉన్న ట్యాగ్లను ధ్రువీకరించిన చోట అవి ఉంచబడ్డాయి. అది విభేదించిన చోట ధ్వని ఫలితమే గెలిచింది. మిగిలిన 3,069 గుర్తించని ఫైళ్లు అంతగా తెలియని Bollywood ట్రాక్లు, ప్రాంతీయ భారతీయ సంగీతం, ధ్వని సరిపోలికకు చాలా పాడైన లేదా చాలా చిన్న ఫైళ్ల మిశ్రమం. అవి మూడంచెల పరిష్కారంలోకి వెళ్లాయి: Shazam ఫలితం → ఉన్న ID3 ట్యాగ్లు (శుభ్రం చేసి, సాధారణీకరణ తొలగించినవి) → చివరి ఆశ్రయంగా ఫైల్ పేరు విశ్లేషణ. తుది కేటలాగ్ వివరాలు చూపిస్తాయి: 6,925 ఎంట్రీలు ID3 ద్వారా పరిష్కారమయ్యాయి (వీలైన చోట Shazamతో ధ్రువీకరించబడ్డాయి లేదా సరిదిద్దబడ్డాయి), 79 Shazam నుంచి మాత్రమే, 156 ఫైల్ పేరు ప్రత్యామ్నాయం నుంచి.
దశ 2–3: భాష సమస్య, కళాకారుల చెల్లాచెదురు సమస్య
ఇంగ్లీష్ ట్రాక్లకు భాష వర్గీకరణ సులభమే కానీ హిందీ దగ్గర వెంటనే కూలిపోయింది. సమస్య: langdetect లిప్యంతరీకరించిన హిందీని (ఇంగ్లీష్ అక్షరాల్లో రాసిన హిందీ, “Tujhe Dekha Toh Yeh Jaana Sanam”) చూసి దాన్ని ఇంగ్లీష్ అని ముద్ర వేస్తుంది. రోమన్ శీర్షిక ఉన్న ప్రతి Bollywood పాట తప్పు సమూహంలో పడింది.
పరిష్కారం స్పష్టమైన భాష సూచన ఫైళ్లు: config/language_hints/ కింద JSON కాన్ఫిగ్లు, వాటిలో తెలిసిన కళాకారులు, విశిష్ట కీవర్డ్లు, భాషా కోడ్లు జాబితా చేయబడతాయి. "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"] ఉన్న Hindi.json ఉంచితే, langdetect ఏమనుకున్నా ఆ కళాకారులు బలవంతంగా హిందీ సమూహంలోకి వెళ్తారు. కోడ్లో భాష గురించి హార్డ్కోడ్ చేసిన జ్ఞానం లేకుండా, పైప్లైన్ వీటిని రన్టైమ్లో లోడ్ చేసింది.
తర్వాత కళాకారుల చెల్లాచెదురు సమస్య వచ్చింది. ప్రాథమిక వర్గీకరణ తర్వాత నా దగ్గర Akon feat. Eminem, Akon ft Snoop Dogg, AKON కోసం వేర్వేరు ఫోల్డర్లు ఉన్నాయి, అన్నీ ఒకే ప్రధాన కళాకారుడివి, మూడు డైరెక్టరీల్లో చెల్లాచెదురుగా. ఏకీకరణ పాస్ (03A_consolidate_by_artist.py) 70% సారూప్యత పరిమితి వద్ద ఫజ్జీ మ్యాచింగ్, ప్రామాణిక పేర్ల కోసం చేత్తో తయారుచేసిన ఓవర్రైడ్ మ్యాప్ ఉపయోగించింది. అది 1,365 ఫోల్డర్ విలీనాలు చేసి గందరగోళాన్ని 968 శుభ్రమైన కళాకారుల డైరెక్టరీలకు తగ్గించింది.
చివరి నిర్మాణ అమలుదారు (03D_titanium_resort.py) ఒక హామీ ఇచ్చింది: అది నడిచిన తర్వాత Sorted/ కింద ప్రతి ఫైల్ Language/Artist/Album/Artist - Title.ext శ్రేణిని పాటిస్తుంది. పాటించనిది మళ్లీ వర్గీకరించబడుతుంది లేదా గుర్తించబడుతుంది. దశ 3 ముగిసే సరికి లైబ్రరీ 7,246 ఫైళ్ల చదునైన కుప్ప నుంచి ఒక్క అనాథ ఫైల్ కూడా లేని నిర్మాణాత్మక శ్రేణిలోకి మారింది.
దశ 4: సమృద్ధీకరణ, మెటాడేటాను విలువైనదిగా చేయడం
ఫైళ్లను సరైన ఫోల్డర్లలో వర్గీకరించడం సగం పని. మిగతా సగం ప్రతి ఫైల్ తనను తాను వివరించుకునేలా చేయడం: సరైన ID3 ట్యాగ్లు, పొందుపరిచిన కవర్ ఆర్ట్, సింక్ చేసిన సాహిత్యం. నేను మూడు బాహ్య మూలాలు ఉపయోగించాను:
- iTunes Search API ప్రామాణిక కళాకారుల పేర్లు, ఆల్బమ్ శీర్షికలు, విడుదల తేదీలు, 1000×1000 కవర్ ఆర్ట్ కోసం. దీనికి API కీ అవసరం లేదు. ప్రాంతం వారీ రేట్ పరిమితులను తప్పించడానికి స్క్రిప్ట్ US, GB దేశ కోడ్ల మధ్య క్వెరీలను తిప్పుతుంది.
- LrcLib సింక్ అయిన సాహిత్యం కోసం (ప్లేయర్లో పదం పదంగా స్క్రోల్ అయ్యేవి). ఉచితం, ఆథెంటికేషన్ అవసరం లేదు.
- Shazam అసలు గుర్తింపు, iTunes ఫలితాలతో ఫజ్జీ మ్యాచింగ్కు సత్య ఆధారంగా.
సమృద్ధీకరణ స్క్రిప్ట్ (04I_polish_and_enrich_v6.py, ఆరో వెర్షన్, ఈ ప్రక్రియ ఎన్ని అరుదైన సందర్భాలను బయటపెట్టిందో అదే చెబుతుంది) ఏ ట్యాగ్ రాసే ముందైనా 14-నమూనా రెజెక్స్ డీనాయిజ్ పాస్ నడుపుతుంది. అది చెత్త భాగాలను తొలగిస్తుంది: నాణ్యత గుర్తులు (128kbps, 320kbps, VBR, HQ), వివరణ అవశేషాలు (official video, full song, dj remix), ఏళ్లుగా ట్యాగ్ ఫీల్డ్లలో పేరుకుపోయిన రకరకాల శబ్దం. Shazam సత్య ఆధారంతో ఫజ్జీగా పోల్చి తారుమారైన కళాకారుడు/శీర్షిక ఫీల్డ్లను పట్టుకుని, వాటిని స్వయంచాలకంగా సరిచేస్తుంది.
ఫలితం: కేటలాగ్లోని 7,160లో 6,733 ట్రాక్లు ఇప్పుడు నిజమైన ఆల్బమ్ మెటాడేటా కలిగి ఉన్నాయి. 103 ట్రాక్లలో పొందుపరిచిన HD కవర్ ఆర్ట్ ఉంది. 25 వాటికి సింక్ అయిన సాహిత్యం ఉంది. మిగిలిన లోటులు ఎక్కువగా iTunes ఇండెక్స్ చేయని ప్రాంతీయ ట్రాక్లు, ఇది తెలిసిన పరిమితి, MusicBrainz ఆధారంగా చేసే భవిష్యత్ సమృద్ధీకరణ పాస్ కోసం నేను దీన్ని నమోదు చేస్తున్నాను.
దశ 5–6: తుది రూపం, Spotify వంతెన
దశ 5 కేటలాగ్ను లాక్ చేసింది. 05I_finalize_catalog.py ID3, Shazam, NLP వర్గీకరణ డేటాను ఒకే final_catalog.jsonలోకి విలీనం చేస్తుంది, 1.9 MB చదవడానికి మాత్రమే ఉండే ఆర్టిఫ్యాక్ట్, దీన్ని తదుపరి వినియోగదారులు ఏకైక సత్య మూలంగా పరిగణిస్తారు. తుది రూపం తర్వాత: సంగీత మూలంలో ఎక్కడా సున్నా వర్గీకరించని ఆడియో ఫైళ్లు. ఆ తర్వాత నేను వాటన్నింటినీ తొలగించాను. 30 GB ఆడియో ఫైళ్లు, మాయమయ్యాయి. .data/లో పైప్లైన్ స్థితి 11 MB, అంటే కేటలాగ్లు, సమృద్ధీకరణ రికార్డులు, Shazam గుర్తింపులు, నిజంగా ముఖ్యమైనది అదే. కేటలాగ్లోని ప్రతి పాటా Spotifyలో ఉంది. స్థానిక ఫైళ్లు కేవలం ముడి సరుకు; మెటాడేటాయే ఉత్పత్తి.
దశ 6 తొలగింపును బాధారహితం చేసింది. డిస్కవరీ సింక్ ఇంజిన్ (06E_spotify_discovery_sync.py) కేటలాగ్ కళాకారులను Spotifyతో సరిపోల్చి, జానర్ ఆధారిత “Essentials” ప్లేలిస్ట్లను స్వయంచాలకంగా సృష్టిస్తుంది. మొదటి సింక్ రన్లో అది 95 మంది కళాకారులను ప్రాసెస్ చేసింది. ప్లేలిస్ట్ సృష్టిలో Spotify 403 (యాప్ డెవలప్మెంట్ మోడ్లో ఉంది) స్వయంచాలకంగా రూపొందిన ప్లేలిస్ట్లు దిగకుండా ఆపింది, ఇది Spotify Developer Dashboardలో ఒక క్లిక్తో సరిపోతుంది, తదుపరి రన్ ముందు నేను దాన్ని పరిష్కరిస్తాను.
దశ 6 అసలు ప్రయోజనం కాదు. అసలు ప్రయోజనం ఏమిటంటే కేటలాగ్ ఎంతగా నిర్మాణాత్మకంగా, సమృద్ధిగా ఉందంటే దాన్ని ఆడియో ఫైళ్లు లేకుండానే AIకి అప్పగించవచ్చు.
దశ 7: AI స్కిల్, అడిగినప్పుడల్లా ప్లేలిస్ట్ క్యూరేషన్
దశలు 1–6 డేటాసెట్ను నిర్మించాయి. దశ 7 దాని పైన ఒక AIని కూర్చోబెడుతుంది.
నేను ఆ స్కిల్ను ClawHubలో ultimate-music-manager పేరుతో విడుదల చేశాను. ఏ OpenClaw-అనుకూల ఏజెంట్ అయినా (Claude Code, Codex, Copilot) దాన్ని ఇన్స్టాల్ చేసి వెంటనే పైప్లైన్ నడపవచ్చు లేదా కేటలాగ్ను ప్రశ్నించవచ్చు. స్కిల్ ప్యాకేజీలో పైప్లైన్ సూచనల పూర్తి సమితి (SKILL.md), ప్రీఫ్లైట్ తనిఖీలు, స్టేటస్ డాష్బోర్డ్ల కోసం సహాయక స్క్రిప్ట్లు, విధ్వంసక చర్యలు నడిచే ముందే ఆపే భద్రతా హుక్ ఉన్నాయి.
ఇక్కడే వారాంతపు ప్రాజెక్ట్ ఫలిస్తుంది. నేను ఇప్పుడు “నా కోసం 90ల Bollywood నోస్టాల్జియా ప్లేలిస్ట్ చేయి” లేదా “ప్రతి Eminem ట్రాక్ను ఆల్బమ్ వారీగా వర్గీకరించి ఇవ్వు” లేదా “నా ఇంగ్లీష్ సేకరణ నుంచి రోడ్ ట్రిప్ మిక్స్ చేయి, ఎక్కువగా రాక్” అని చెప్పగలను, ఏజెంట్ దగ్గర దాన్ని నిజంగా చేయడానికి నిర్మాణాత్మక మెటాడేటా ఉంది: కళాకారుడు, శీర్షిక, ఆల్బమ్, భాష, జానర్. అది final_catalog.json చదివి, నేను సాధారణ భాషలో వివరించే ఏ ప్రమాణంతోనైనా వడపోసి, ఫలితాన్ని దశ 6 సింక్ ఇంజిన్ ద్వారా Spotifyకి పంపుతుంది. స్థానిక ఆడియో ఫైళ్లు అవసరం లేదు: కేటలాగ్, ఒక Spotify సబ్స్క్రిప్షన్ మాత్రమే.
తుది కేటలాగ్ ఇకపై ఫైల్ పేర్ల చదునైన జాబితా కాదు. ఇది విడుదలైన AI స్కిల్ వెనుక కూర్చున్న శోధించదగిన డేటాసెట్, ఇది సాధారణ భాషను క్యూరేట్ చేసిన ప్లేలిస్ట్లుగా మారుస్తుంది, పూర్తిగా నా స్వంత సంగీతం నుంచి తీసిన మెటాడేటాతో నిర్మించబడింది, నేను దేనిపై పెరిగానో తెలియని అల్గారిథమ్ నుంచి కాదు.
రాజీలు
57.6% Shazam గుర్తింపు రేటు అతిపెద్ద ఆశ్చర్యం. ధ్వని ఫింగర్ప్రింటింగ్ అద్భుత పరిష్కారం అవుతుందని ఊహించాను: ఆడియో ఇవ్వండి, జవాబు పొందండి. ప్రధాన స్రవంతి పాశ్చాత్య సంగీతానికి అది అలాగే ఉంది. ప్రాంతీయ భారతీయ సంగీతానికి, ముఖ్యంగా పాత Bollywood ట్రాక్లకు, భక్తి రికార్డింగ్లకు, Shazam డేటాబేస్లో కవరేజ్ కేవలం లేదు. మూడంచెల ప్రత్యామ్నాయం (Shazam → ID3 → ఫైల్ పేరు) చాలావాటిని పట్టుకుంది, కానీ 156 ట్రాక్లు ఇప్పటికీ ఫైల్ పేరు విశ్లేషణతో మాత్రమే పరిష్కారమయ్యాయి, అంటే వాటి మెటాడేటా ఒకప్పుడు డౌన్లోడ్ చేసినవారు టైప్ చేసినంత మంచిదే. ఈ 156 ఎంట్రీలు కేటలాగ్లో అతి తక్కువ నమ్మకమైన రికార్డులు.
సమృద్ధీకరణ స్క్రిప్ట్ ఆరు వెర్షన్లు (04A నుంచి 04I వరకు) తమ కథను తామే చెబుతాయి. ప్రతి వెర్షన్ ఉంది ఎందుకంటే ముందున్నది నేను ఊహించని ఒక అరుదైన సందర్భం దగ్గర విరిగింది: Mutagen సేవ్ చేయలేని మిశ్రమ ID3v2.3/v2.4 హెడర్లు, ఫజ్జీ క్వెరీకి iTunes పూర్తిగా వేరే ట్రాక్ ఇవ్వడం, డీనాయిజ్ పాస్ మెరుగుపరచడానికి బదులు ఇంకా పాడుచేసిన తారుమారైన కళాకారుడు/శీర్షిక ఫీల్డ్లు. నేను ప్రతి వెర్షన్ను చారిత్రక రికార్డుగా రెపోలో ఉంచాను. 04A నుంచి 04I వరకు క్రమంగా చదవడం, సంగీత లైబ్రరీ మీపైకి ఎన్ని రకాల మెటాడేటా అరుదైన సందర్భాలను విసరగలదో అర్థం చేసుకోవడానికి వేగవంతమైన మార్గం.
లిప్యంతరీకరించిన హిందీపై langdetect వైఫల్యం గంటల తరబడి సమయం కాల్చింది. క్లాసిఫైయర్ పూర్తి ఆత్మవిశ్వాసంతో తప్పు చేస్తోందని గ్రహించే సరికి 200కు పైగా Bollywood ట్రాక్లు ఇంగ్లీష్ సమూహంలో పడి ఉన్నాయి. సూచన ఫైళ్ల వ్యవస్థే పరిష్కారం, కానీ ఇది చేతిపని: ప్రతి భాషకు ఎవరో కళాకారుల జాబితాలు, కీవర్డ్లు సిద్ధం చేయాలి. రెండు భాషల సేకరణకు (ఇంగ్లీష్, హిందీ) ఇది నిర్వహించదగినది. 10కి మించిన భాషల బహుభాషా లైబ్రరీకి ఇది గణనీయమైన ముందస్తు పెట్టుబడి అవుతుంది.
సరిపోలని వాటి నివేదికలోని 690 ఎంట్రీలు, Shazam గుర్తింపుతో సరిపోలని ఫలితాన్ని iTunes ఇచ్చిన ట్రాక్లు. కొన్ని చెల్లుబాటయ్యే ప్రత్యామ్నాయ వెర్షన్లు (లైవ్ రికార్డింగ్లు, రీమాస్టర్లు). కొన్ని iTunes ఫజ్జీ శోధన నుంచి వచ్చిన నిజమైన తప్పు సరిపోలికలు. సమృద్ధీకరణ స్క్రిప్ట్ వీటిని లాగ్ చేస్తుంది కానీ Shazam సత్య ఆధారాన్ని ఓవర్రైడ్ చేయదు, ఇది ఒక జాగ్రత్త ఎంపిక, అప్పుడప్పుడు ట్రాక్ను తప్పుగా ట్యాగ్ చేయడం కంటే తక్కువ సమృద్ధితో వదిలేస్తుంది.
నేను నేర్చుకున్నది
నా బిడ్డకు ఆ పాటలు వినే అవకాశం దక్కింది. అసలు ఉద్దేశ్యం అదే, అది ఇంజినీరింగ్లో దాదాపు తప్పిపోయింది. ట్యాగ్లు లేని 7,246 ఆడియో ఫైళ్ల కుప్ప డేటా సమస్య, సంగీత సేకరణ కాదు, డేటా సమస్యల్లోనే AI టూలింగ్ ఇప్పుడు నేర్పరిగా మారింది. నేను ఒక వారాంతంలో నిర్మించిన పైప్లైన్కు కొన్ని ఏళ్ల క్రితం చేత్తో వర్గీకరించడానికి వారాలు పట్టేవి. ఇప్పుడు కేటలాగ్ ఎంతగా నిర్మాణాత్మకంగా ఉందంటే, ఒక AI స్కిల్ సెకన్లలో నాకోసం ప్లేలిస్ట్ చేస్తుంది, చేత్తో సరిదిద్దే ఓపిక నాకు ఎప్పటికీ ఉండని మెటాడేటాతో. నేను 30 GB ఆడియోను తొలగించి 11 MB JSON ఉంచాను. ఫైళ్లు ఎప్పుడూ ఉద్దేశ్యం కాదు, డేటాయే, డేటాసెట్లు చక్రవడ్డీలా పెరుగుతాయి.

రచయిత
Rohit BuraniAI ఇంజినీర్. ల్యాబ్ నుంచి లోకల్-ఫస్ట్ సిస్టమ్లు, సెల్ఫ్-హోస్టెడ్ ఇన్ఫ్రాస్ట్రక్చర్, స్వయంచాలక టూల్స్ నిర్మిస్తారు.