Sonic Phoenix: 7,246 विसरलेली गाणी मृत्यूतून परत आणणे
हा इंग्रजी मूळ लेखाचा यांत्रिक अनुवाद आहे. काही बारकावे हरवू शकतात, म्हणून संदर्भासाठी इंग्रजी आवृत्तीच ग्राह्य धरावी. मूळ लेख इंग्रजीत वाचा
थोडक्यात
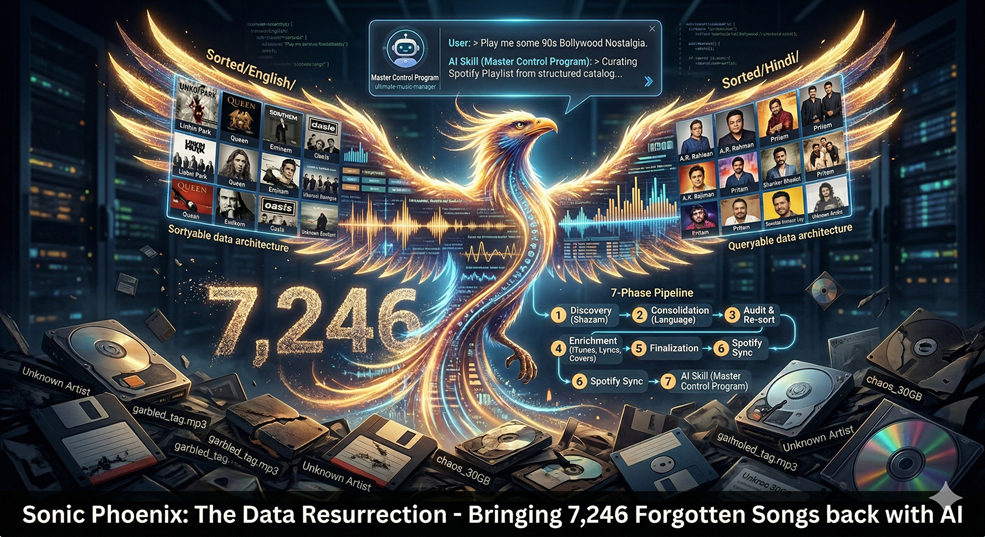
माझ्या मुलाने मला सांगितलं की त्याच्या वयात मी जी गाणी ऐकायचो ती लावा. साधी विनंती. मी हो म्हणालो, धूळ बसलेला एक एक्स्टर्नल ड्राइव्ह काढला, जोडला आणि वर्षानुवर्षं हात न लावलेला एक फोल्डर उघडला. जे सापडलं ते म्हणजे 7,246 ऑडिओ फाइल्स, ज्यांचा मेटाडेटा एकतर चुकीचा, किंवा गायब, किंवा अर्थहीन: कलाकाराच्या रकान्यात ट्रॅक नंबर, अल्बमची नावं ज्यांना काही अर्थ नाही, शीर्षकं ज्यांचा खऱ्या गाण्याशी काहीही संबंध नाही. मला एकही ट्रॅक नावाने सापडला नाही. त्या ड्राइव्हवर मी ज्यावर वाढलो ते सगळं होतं (Eminem, Linkin Park, A.R. Rahman, Pritam, Queen), वर्षानुवर्षं रिप करणं, कन्व्हर्ट करणं आणि उपकरणांमध्ये फाइल्स फिरवणं यातून साचलेल्या तुटक्या टॅगच्या थरांखाली गाडलेलं. त्यानंतरचा वीकेंड Sonic Phoenix बनला.
आर्किटेक्चर
पाइपलाइन सात टप्प्यांत विभागलेली आहे, प्रत्येक टप्पा लहान स्क्रिप्ट्सची एक साखळी जी आपली स्थिती डिस्कवर लिहिते. तुम्ही कोणत्याही टप्प्यानंतर थांबू शकता, मधला JSON तपासू शकता, गोष्टी हाताने दुरुस्त करू शकता आणि काम पुन्हा न करता पुढे चालू करू शकता. यात कोणतीही हुशारी नाही, फक्त शिस्तबद्ध स्टेट मॅनेजमेंट जे गोंधळलेल्या समस्येला सोडवता येण्याजोगं बनवतं.
| टप्पा | उद्देश | मुख्य मेट्रिक |
|---|---|---|
| 1 - शोध | Shazam द्वारे प्रत्येक फाइलचा ध्वनिक फिंगरप्रिंट | 7,246 फाइल्स स्कॅन, 4,177 ओळखल्या (57.6%) |
| 2 - एकत्रीकरण | SHA-256 कॅटलॉग आणि भाषा वर्गीकरण | 2 भाषा-गटांत 7,160 कॅटलॉग नोंदी |
| 3 - ऑडिट आणि पुन्हा वर्गीकरण | विखुरलेले कलाकार एकत्र करणं, रचना लागू करणं | 1,365 एकत्रीकरण हालचाली, 968 अनोखे कलाकार फोल्डर |
| 4 - समृद्धीकरण | iTunes मेटाडेटा, LrcLib चे शब्द, कव्हर आर्ट | 6,733 ट्रॅक खऱ्या अल्बम डेटासह |
| 5 - अंतिम रूप | स्वच्छता, आकुंचन, मास्टर कॅटलॉग लॉक | 0 अवर्गीकृत फाइल्स शिल्लक |
| 6 - Spotify सिंक | लायब्ररीचं प्रतिबिंब आणि प्लेलिस्ट आपोआप तयार करणं | 95 कलाकार डिस्कव्हरी इंजिनद्वारे सिंक |
| 7 - AI स्किल (ClawHub) | OpenClaw एजंटद्वारे मागणीनुसार प्लेलिस्ट तयार करणं | ClawHub वर ultimate-music-manager म्हणून प्रकाशित |
लक्ष्य रचना आहे Sorted/<Language>/<Artist>/<Album>/<Artist> - <Title>.<ext>. माझ्या संग्रहातून दोन भाषा-गट बाहेर आले: इंग्रजी (3,621 ट्रॅक) आणि हिंदी (1,410 ट्रॅक). वर्गीकरण कोडमध्ये हार्डकोड केलेलं नाही, ते पूर्णपणे तुम्ही config/language_hints/ मध्ये ठेवलेल्या JSON सूचना-फाइल्सवर चालतं. तुमचा संग्रह फ्रेंच आणि जपानी असेल, तर पाइपलाइन Sorted/French/ आणि Sorted/Japanese/ तयार करते, आणि दुसरं काही नाही.
शिखरावर, ऑडिओ फाइल्स हटवण्यापूर्वी, वर्गीकृत लायब्ररी अशी दिसत होती:
T:\Music\
├── Sorted/
│   ├── English/          # 3,621 tracks
│   │   ├── Eminem/       # 125 tracks
│   │   ├── Oasis/        # 80 tracks
│   │   ├── Pitbull/      # 68 tracks
│   │   ├── Nickelback/   # 68 tracks
│   │   ├── Evanescence/  # 64 tracks
│   │   ├── Metallica/    # 59 tracks
│   │   ├── Queen/        # 57 tracks
│   │   └── ... (600+ more artists)
│   └── Hindi/            # 1,410 tracks
│       ├── Pritam/       # 122 tracks
│       ├── Sonu Nigam/       # 63 tracks
│       ├── A.R. Rahman/  # 44 tracks
│       ├── Shankar Ehsaan Loy/ # 39 tracks
│       └── ... (350+ more artists)
├── .data/                # 11 MB of pipeline state
│   ├── shazam_hash_results.json   # 1.3 MB - ground-truth identifications
│   ├── catalog.json               # 3.8 MB - master SHA-256 catalog
│   ├── final_catalog.json         # 1.9 MB - read-only canonical output
│   └── enrichment_progress.json   # 642 KB - per-file enrichment status
└── sonic-phoenix/        # the pipeline repo
बांधणी
टप्पा 1: प्रत्येक टॅगकडे दुर्लक्ष करा, फक्त ऑडिओवर विश्वास ठेवा
पहिला निर्णय सर्वात महत्त्वाचा होता: अस्तित्वात असलेल्या मेटाडेटावर विश्वास ठेवणं थांबवणं. या फाइल्समधले ID3 टॅग फक्त अपूर्ण नव्हते, ते सक्रियपणे दिशाभूल करणारे होते. कलाकाराच्या रकान्यात ट्रॅक नंबर होते. अल्बमची नावं निरर्थक स्ट्रिंग होती. शीर्षकांचा खऱ्या गाण्याशी मेळ नव्हता. काही टॅग बरोबर होते, पण बाहेरच्या सत्य-स्रोताशिवाय कोणते ते कळायला मार्ग नव्हता.
तो सत्य-स्रोत होता ShazamIO चं ध्वनिक फिंगरप्रिंटिंग इंजिन. टॅग काय म्हणतात आणि ऑडिओ प्रत्यक्षात काय आहे याची तपासणी करण्यासाठी मी प्रत्येक फाइल त्यातून चालवली. स्क्रिप्ट (01D_shazam_all_files.py) 20 समांतर Shazam लुकअप चालवते, प्रत्येक 100 फाइल्सनंतर निकाल डिस्कवर लिहिते आणि पूर्णपणे पुन्हा सुरू करता येण्याजोगी आहे: वीकेंडमध्ये मी ती तीनदा थांबवली आणि प्रत्येक वेळी ती नेमकी तिथूनच सुरू झाली जिथे थांबली होती.
7,246 फाइल्सपैकी Shazam ने 4,177 पूर्ण खात्रीने ओळखल्या, म्हणजे 57.6% ओळख दर. जिथे Shazam ने अस्तित्वात असलेल्या टॅगची पुष्टी केली, ते ठेवले गेले. जिथे तो असहमत झाला, तिथे ध्वनिक निकाल जिंकला. उरलेल्या 3,069 न ओळखलेल्या फाइल्स म्हणजे अप्रसिद्ध Bollywood ट्रॅक, प्रादेशिक भारतीय संगीत आणि ध्वनिक जुळणीसाठी खूप खराब किंवा खूप लहान फाइल्स यांचं मिश्रण होतं. त्या तीन-स्तरीय उपायातून गेल्या: Shazam निकाल → अस्तित्वात असलेले ID3 टॅग (स्वच्छ केलेले आणि अ-सामान्यीकृत) → शेवटचा उपाय म्हणून फाइलनावाचं विश्लेषण. अंतिम कॅटलॉग तपशील दाखवतो: 6,925 नोंदी ID3 द्वारे सोडवल्या (शक्य तिथे Shazam ने पुष्टी केलेल्या किंवा सुधारलेल्या), 79 केवळ Shazam कडून, आणि 156 फाइलनावाच्या पर्यायातून.
टप्पा 2–3: भाषेची समस्या आणि कलाकारांच्या विखुरलेपणाची समस्या
इंग्रजी ट्रॅकसाठी भाषा वर्गीकरण सोपं होतं, पण हिंदीवर ते लगेच कोलमडलं. समस्या: langdetect लिप्यंतरित हिंदी (इंग्रजी अक्षरांत लिहिलेली हिंदी, “Tujhe Dekha Toh Yeh Jaana Sanam”) पाहतो आणि तिला इंग्रजी ठरवतो. रोमन शीर्षक असलेलं प्रत्येक Bollywood गाणं चुकीच्या गटात गेलं.
उपाय होता स्पष्ट भाषा-सूचना फाइल्स: config/language_hints/ अंतर्गत JSON कॉन्फिग ज्यांत ओळखीचे कलाकार, वैशिष्ट्यपूर्ण कीवर्ड आणि भाषा कोड नोंदवलेले असतात. "artists": ["Pritam", "A.R. Rahman", "Sonu Nigam"] असलेली एक Hindi.json ठेवली की ते कलाकार langdetect काहीही म्हणो तरी जबरदस्तीने हिंदी गटात जातात. पाइपलाइन या फाइल्स रनटाइमला लोड करत होती, कोडमध्ये भाषेचं कोणतंही हार्डकोड ज्ञान न ठेवता.
मग आला कलाकारांच्या विखुरलेपणाचा प्रश्न. सुरुवातीच्या वर्गीकरणानंतर माझ्याकडे Akon feat. Eminem, Akon ft Snoop Dogg आणि AKON चे वेगळे फोल्डर होते, सगळे एकाच मुख्य कलाकाराचे, तीन डिरेक्टरींमध्ये विखुरलेले. एकत्रीकरण पास (03A_consolidate_by_artist.py) ने 70% साम्य मर्यादेवर फज्जी मॅचिंग आणि प्रमाणित नावांसाठी हाताने बनवलेला ओव्हरराइड नकाशा वापरला. त्याने 1,365 फोल्डर विलीन करून गोंधळ 968 स्वच्छ कलाकार डिरेक्टरींवर आणला.
शेवटचा संरचनात्मक अंमलकर्ता (03D_titanium_resort.py) ने एक हमी दिली: तो चालल्यानंतर Sorted/ खालची प्रत्येक फाइल Language/Artist/Album/Artist - Title.ext श्रेणीरचना पाळते. जी पाळत नाही ती पुन्हा वर्गीकृत होते किंवा चिन्हांकित होते. टप्पा 3 संपेपर्यंत लायब्ररी 7,246 फाइल्सच्या सपाट ढिगाऱ्यावरून एकही अनाथ फाइल नसलेल्या संरचित श्रेणीरचनेत पोहोचली होती.
टप्पा 4: समृद्धीकरण, मेटाडेटाला किंमत देणं
फाइल्स योग्य फोल्डरमध्ये लावणं हे अर्धं काम आहे. उरलेलं अर्धं म्हणजे प्रत्येक फाइलला स्वतःची ओळख सांगता येईल असं करणं: योग्य ID3 टॅग, एम्बेड केलेलं कव्हर आर्ट, सिंक्रोनाइझ केलेले शब्द. मी तीन बाह्य स्रोत वापरले:
- iTunes Search API प्रमाणित कलाकार नावं, अल्बम शीर्षकं, प्रकाशन तारखा आणि 1000×1000 कव्हर आर्टसाठी. यासाठी API की लागत नाही. स्क्रिप्ट प्रदेशानुसार दर-मर्यादा टाळण्यासाठी US आणि GB देश कोड्समध्ये क्वेरी फिरवते.
- LrcLib सिंक्रोनाइझ केलेल्या शब्दांसाठी (जे प्लेयरमध्ये शब्दागणिक स्क्रोल होतात). मोफत, ऑथशिवाय.
- Shazam ची मूळ ओळख iTunes निकालांशी फज्जी जुळणीसाठी सत्याचा आधार म्हणून.
समृद्धीकरण स्क्रिप्ट (04I_polish_and_enrich_v6.py, सहावी आवृत्ती, ज्यावरून या प्रक्रियेने किती एज केसेस उघड केल्या ते कळतं) कोणताही टॅग लिहिण्यापूर्वी 14-पॅटर्नचा रेजेक्स डिनॉइज पास चालवते. ती कचरा तुकडे काढते: गुणवत्ता चिन्हं (128kbps, 320kbps, VBR, HQ), वर्णनाचे अवशेष (official video, full song, dj remix) आणि वर्षानुवर्षं टॅग रकान्यांत साचलेला विविध गोंगाट. ती Shazam च्या सत्याच्या आधाराशी फज्जी तुलना करून उलटलेले कलाकार/शीर्षक रकाने पकडते आणि आपोआप दुरुस्त करते.
निकाल: कॅटलॉगमधल्या 7,160 पैकी 6,733 ट्रॅकवर आता खरा अल्बम मेटाडेटा आहे. 103 ट्रॅकमध्ये एम्बेड केलेलं HD कव्हर आर्ट आहे. 25 मध्ये सिंक्रोनाइझ केलेले शब्द आहेत. उरलेली तफावत बहुतेक प्रादेशिक ट्रॅकची आहे ज्यांना iTunes इंडेक्स करत नाही, ही एक ज्ञात मर्यादा आहे जी मी MusicBrainz विरुद्ध भविष्यातील समृद्धीकरण पाससाठी नोंदवून ठेवत आहे.
टप्पा 5–6: अंतिम रूप आणि Spotify पूल
टप्पा 5 ने कॅटलॉग लॉक केला. 05I_finalize_catalog.py ID3, Shazam आणि NLP वर्गीकरण डेटा एकत्र करून एकच final_catalog.json बनवते, 1.9 MB ची फक्त-वाचनीय कलाकृती जिला पुढचे वापरकर्ते एकमेव सत्य-स्रोत मानतात. अंतिम रूपानंतर: संगीताच्या मुळात कुठेही शून्य अवर्गीकृत ऑडिओ फाइल्स. आणि मग मी त्या सगळ्या हटवल्या. 30 GB ऑडिओ फाइल्स, गेल्या. .data/ मधले पाइपलाइन स्टेटचे 11 MB, म्हणजे कॅटलॉग, समृद्धीकरण नोंदी आणि Shazam च्या ओळखी, तेच प्रत्यक्षात महत्त्वाचं आहे. कॅटलॉगमधलं प्रत्येक गाणं Spotify वर आहे. स्थानिक फाइल्स फक्त कच्चा माल होत्या; मेटाडेटा हेच उत्पादन आहे.
टप्पा 6 ने हटवणं वेदनारहित केलं. डिस्कव्हरी सिंक इंजिन (06E_spotify_discovery_sync.py) कॅटलॉगमधील कलाकारांना Spotify शी जुळवतं आणि शैलीनुसार “Essentials” प्लेलिस्ट आपोआप तयार करतं. पहिल्या सिंक रनमध्ये त्याने 95 कलाकार प्रोसेस केले. प्लेलिस्ट तयार करताना Spotify चा 403 (ॲप डेव्हलपमेंट मोडमध्ये होतं) आपोआप तयार झालेल्या प्लेलिस्ट उतरू देत नव्हता, जो Spotify Developer Dashboard मध्ये एका क्लिकने सुटतो आणि पुढच्या रनपूर्वी मी तो सोडवेन.
टप्पा 6 हे बक्षीस नाही. बक्षीस म्हणजे कॅटलॉग इतका संरचित आणि समृद्ध आहे की तो AI च्या हातात देता येतो, ऑडिओ फाइल्सशिवाय.
टप्पा 7: AI स्किल, मागणीनुसार प्लेलिस्ट तयार करणं
टप्पे 1–6 ने डेटासेट बनवला. टप्पा 7 त्याच्या वर एक AI बसवतो.
मी हे स्किल ClawHub वर ultimate-music-manager या नावाने प्रकाशित केलं आहे. कोणताही OpenClaw-सुसंगत एजंट (Claude Code, Codex, Copilot) ते इन्स्टॉल करून लगेच पाइपलाइन चालवू शकतो किंवा कॅटलॉगला प्रश्न विचारू शकतो. स्किल पॅकेजमध्ये पाइपलाइनच्या सूचनांचा संपूर्ण संच (SKILL.md), प्रीफ्लाइट तपासणी आणि स्टेटस डॅशबोर्डसाठी मदतनीस स्क्रिप्ट्स आणि विध्वंसक क्रिया चालण्यापूर्वी अडवणारा सुरक्षा हुक आहे.
इथे वीकेंड प्रकल्पाचं फळ मिळतं. आता मी म्हणू शकतो “माझ्यासाठी 90 च्या दशकातील Bollywood नॉस्टॅल्जिया प्लेलिस्ट बनव” किंवा “मला प्रत्येक Eminem ट्रॅक अल्बमनुसार लावून दे” किंवा “माझ्या इंग्रजी संग्रहातून रोड ट्रिप मिक्स बनव, बरंचसं रॉक”, आणि एजंटकडे ते खरंच करायला संरचित मेटाडेटा आहे: कलाकार, शीर्षक, अल्बम, भाषा, शैली. तो final_catalog.json वाचतो, मी साध्या भाषेत वर्णन केलेल्या कोणत्याही निकषाने गाळतो, आणि निकाल टप्पा 6 च्या सिंक इंजिनमार्फत Spotify कडे पाठवतो. स्थानिक ऑडिओ फाइल्सची गरज नाही: फक्त कॅटलॉग आणि एक Spotify सबस्क्रिप्शन.
अंतिम कॅटलॉग आता फाइलनावांची सपाट यादी नाही. तो प्रकाशित AI स्किलमागे बसलेला शोधण्याजोगा डेटासेट आहे, जो साध्या भाषेला तयार केलेल्या प्लेलिस्टमध्ये बदलतो, पूर्णपणे माझ्या स्वतःच्या संगीतातून काढलेल्या मेटाडेटावर आधारित, मी कशावर वाढलो हे माहीतच नसलेल्या अल्गोरिदमवर नाही.
तडजोडी
57.6% Shazam ओळख दर हा सर्वात मोठा आश्चर्याचा धक्का होता. मला वाटलं होतं की ध्वनिक फिंगरप्रिंटिंग हा रामबाण उपाय असेल: ऑडिओ द्या, उत्तर मिळवा. मुख्य प्रवाहातील पाश्चात्य संगीतासाठी ते तसं होतं. प्रादेशिक भारतीय संगीतासाठी, विशेषतः जुने Bollywood ट्रॅक आणि भक्ती रेकॉर्डिंगसाठी, Shazam च्या डेटाबेसमध्ये कव्हरेजच नव्हतं. तीन-स्तरीय पर्यायाने (Shazam → ID3 → फाइलनाव) बहुतेक पकडले, पण 156 ट्रॅक तरीही फक्त फाइलनावाच्या विश्लेषणाने सोडवले गेले, म्हणजे त्यांचा मेटाडेटा मूळ डाउनलोड करणाऱ्याने जे टाइप केलं तितकाच चांगला आहे. या 156 नोंदी कॅटलॉगमधील सर्वात कमी विश्वासार्ह नोंदी आहेत.
समृद्धीकरण स्क्रिप्टच्या सहा आवृत्त्या (04A ते 04I पर्यंत) स्वतःची गोष्ट स्वतः सांगतात. प्रत्येक आवृत्ती आहे कारण आधीची एखाद्या अशा एज केसवर तुटली जिचा मी अंदाज केला नव्हता: मिश्र ID3v2.3/v2.4 हेडर जे Mutagen सेव्ह करू शकला नाही, iTunes ने फज्जी क्वेरीसाठी पूर्णपणे वेगळा ट्रॅक परत करणं, उलटलेले कलाकार/शीर्षक रकाने जे डिनॉइज पासने सुधारण्याऐवजी आणखी बिघडवले. मी प्रत्येक आवृत्ती ऐतिहासिक नोंद म्हणून रेपोमध्ये ठेवली आहे. 04A पासून 04I पर्यंत क्रमाने वाचणं हा संगीत लायब्ररी तुमच्यावर किती प्रकारच्या मेटाडेटा एज केसेस फेकू शकते हे समजून घेण्याचा सर्वात जलद मार्ग आहे.
लिप्यंतरित हिंदीवर langdetect चं अपयश तासनतास जाळून गेलं. माझ्याकडे 200 पेक्षा जास्त Bollywood ट्रॅक इंग्रजी गटात पडलेले होते, तेव्हा कुठे समजलं की वर्गीकारक पूर्ण आत्मविश्वासाने चुकतोय. सूचना-फाइल प्रणाली हा उपाय होता, पण हे हाताचं काम आहे: कोणालातरी प्रत्येक भाषेसाठी कलाकार याद्या आणि कीवर्ड तयार करावे लागतात. दोन भाषांच्या संग्रहासाठी (इंग्रजी आणि हिंदी) हे सांभाळता येण्यासारखं होतं. 10 पेक्षा जास्त भाषांच्या बहुभाषिक लायब्ररीसाठी ही मोठी आगाऊ गुंतवणूक ठरेल.
विसंगती अहवालातल्या 690 नोंदी म्हणजे असे ट्रॅक जिथे iTunes ने Shazam च्या ओळखीशी न जुळणारा निकाल दिला. काही वैध पर्यायी आवृत्त्या होत्या (लाइव्ह रेकॉर्डिंग, रीमास्टर). काही iTunes च्या फज्जी शोधातून आलेल्या खऱ्या चुकीच्या जुळण्या होत्या. समृद्धीकरण स्क्रिप्ट यांची नोंद ठेवते पण Shazam चा सत्याचा आधार ओव्हरराइड करत नाही, एक सावध निवड जी कधीकधी ट्रॅक चुकीचा टॅग करण्याऐवजी कमी समृद्ध ठेवते.
मी काय शिकलो
माझ्या मुलाने गाणी ऐकली. संपूर्ण उद्देश तोच होता, आणि तो जवळजवळ अभियांत्रिकीत हरवला. 7,246 टॅगशिवाय ऑडिओ फाइल्सचा ढीग ही डेटाची समस्या आहे, संगीताचा संग्रह नाही, आणि डेटाच्या समस्या म्हणजे नेमकं तेच ज्यात AI टूलिंग आता चांगलं झालं आहे. एका वीकेंडमध्ये मी जी पाइपलाइन बनवली, तिला काही वर्षांपूर्वी हाताने वर्गीकरण करायला आठवडे लागले असते. आता कॅटलॉग इतका संरचित आहे की एक AI स्किल सेकंदांत माझ्यासाठी प्लेलिस्ट बनवतं, अशा मेटाडेटावरून जो हाताने नीट लावायचा संयम माझ्याकडे कधीच नसता. मी 30 GB ऑडिओ हटवला आणि 11 MB JSON ठेवला. फाइल्स कधीच उद्देश नव्हत्या, डेटा होता, आणि डेटासेट चक्रवाढ होतात.

लेखक
Rohit BuraniAI इंजिनिअर, जे लॅबमधून लोकल-फर्स्ट सिस्टीम, सेल्फ-होस्टेड इन्फ्रास्ट्रक्चर आणि स्वायत्त टूल्स तयार करतात.